多模态大模型能读懂脊柱X光片吗?SpineXR-VQA临床校验数据集与评测基准解读
印度与泰国联合团队在 ACM Transactions on Computing for Healthcare 发布脊柱X光视觉问答数据集 SpineXR-VQA,含 2187 张X光片、8272 个经10位骨科专家校验的开放式问答对,覆盖异常/严重程度/位置/诊断/治疗/推理6类临床维度,并评测15款多模态大模型,发现现有模型仍难捕捉解剖保真度等诊断细节。
研究背景:脊柱疾病如此高发,AI 问答为何长期"缺数据、缺标准"?
脊柱相关疾病是全球最常见的一类肌肉骨骼问题。从办公人群的颈椎病、腰椎间盘突出,到老年人因骨质疏松导致的椎体压缩性骨折,再到需要外科干预的脊柱侧弯与椎管狭窄,脊柱影像几乎贯穿骨科与影像科的日常工作。X 光片凭借低成本、低辐射、易获取的优势,至今仍是脊柱异常初筛的首选工具。
然而在医学视觉问答(VQA,Visual Question Answering)这条 AI 赛道上,脊柱却长期处于"被忽视"的状态。所谓医学 VQA,是指让模型在看完一张医学影像后,用自然语言回答临床问题——例如"这张片子里有没有椎体塌陷?““病灶在哪个节段?"。近年来这一方向在肺炎、肿瘤、神经影像等领域进展显著,但针对脊柱与肌肉骨骼的公开数据集和评测协议几乎空白。
更关键的问题在于"标准”。现有的大多数医学影像数据集做的是"分类”——给模型一张图,让它从几个固定选项里挑一个答案。但真实临床场景里,医生之间的沟通是描述性、开放式的:既要说出异常是什么,还要判断严重程度、定位到具体节段、给出诊断与治疗建议,甚至解释推理依据。分类式数据集无法刻画这种临床解读的完整链条,这正是脊柱 AI 问答迟迟难以落地的症结所在。
创新点:SpineXR-VQA 如何用"临床校验"补上这块短板?
针对上述空白,印度与泰国联合团队在 ACM 旗下期刊 ACM Transactions on Computing for Healthcare 上发布了 SpineXR-VQA——一个开源、临床落地、经过专家校验的脊柱 X 光视觉问答数据集与评测基准。
它的创新之处可以概括为三点:
- 开放式问答而非选择题:数据集的 8272 个问答对全部是开放式(open-ended)的,模型需要生成描述性、诊断性的回答,而不是从选项里猜答案。
- 六类临床维度:问答对覆盖异常(abnormality)、严重程度(severity)、位置(location)、诊断(diagnosis)、治疗(treatment)、推理(reasoning)六个经专家验证的类别,忠实还原了临床解读的完整视角。
- 专家双重校验:10 位来自印度和泰国的骨科专家对全部问答对进行验证,既保证了地理与临床背景的多样性,也把标注质量提到了一个新的可信度水平。
一句话,SpineXR-VQA 想回答的不只是"模型能不能识别病变",而是"模型能不能像医生一样,把一张脊柱 X 光片讲明白"。
数据集构建方法:2187 张 X 光片如何变成 8272 个专家级问答?
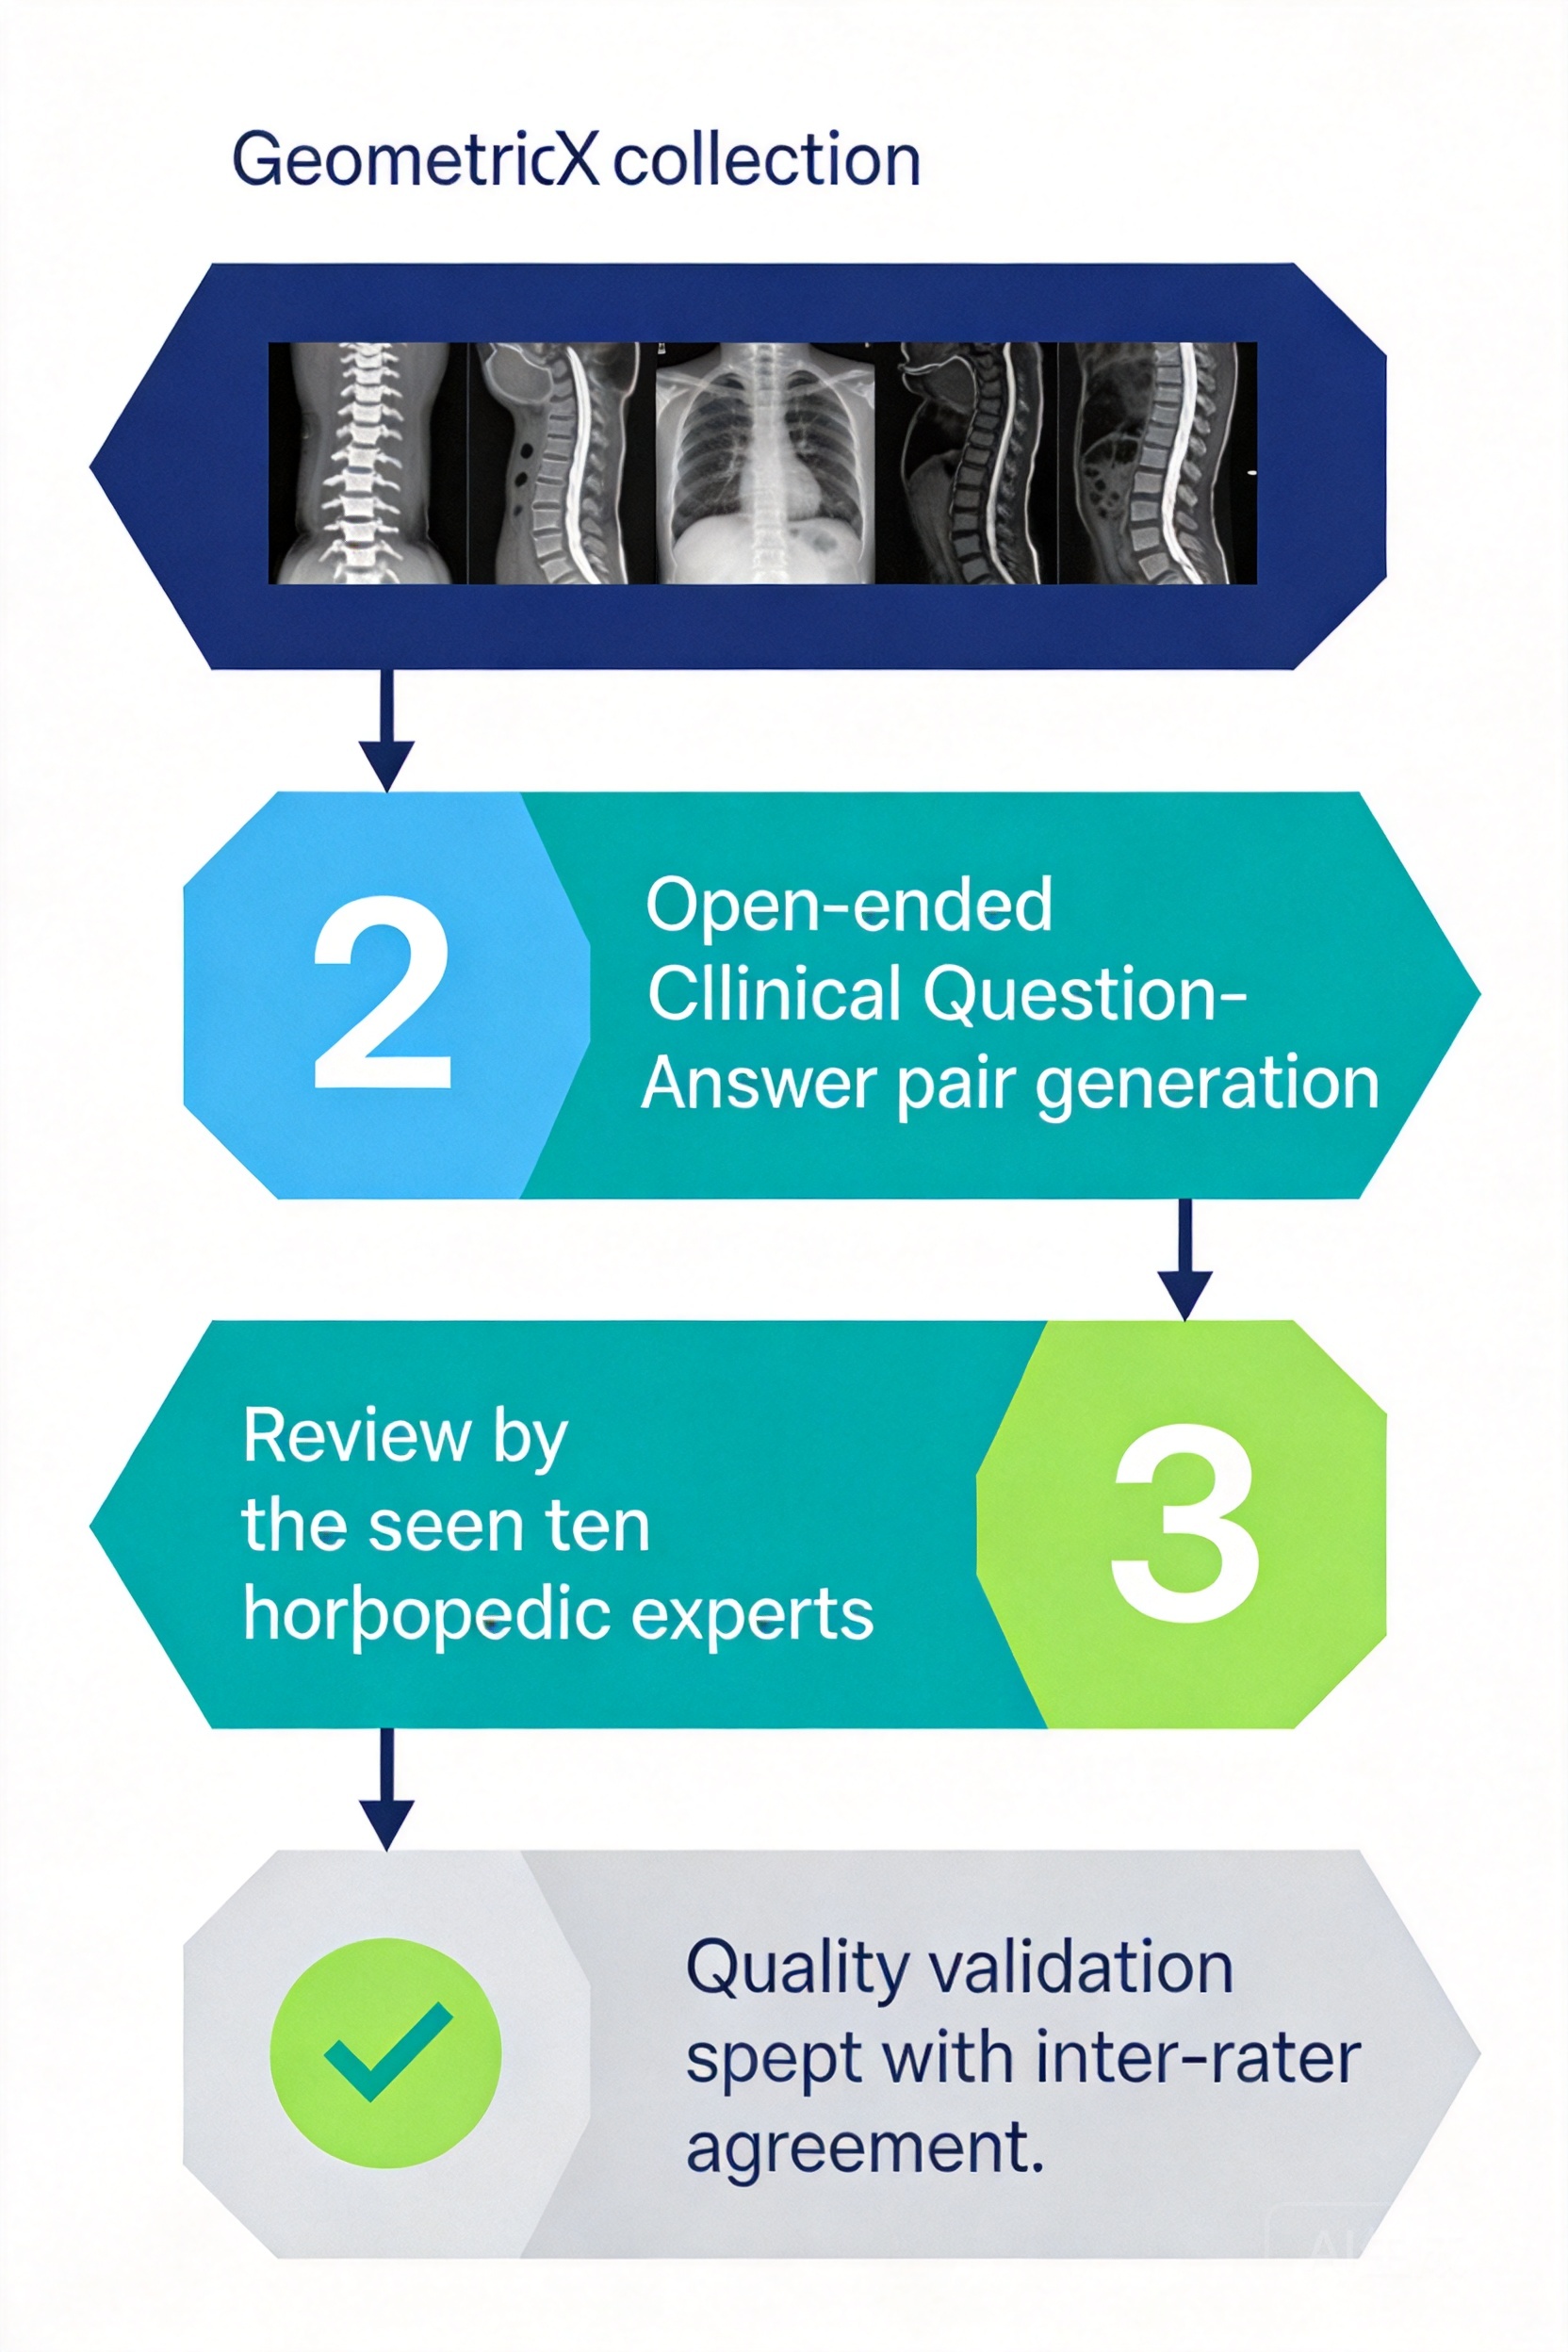
SpineXR-VQA 的构建,本质上是一套"影像 + 专家问答 + 一致性质检"的工程化流程。
在数据层面,团队收集了 2187 张脊柱 X 光片,并围绕这些影像生成了 8272 个开放式问答对。每个问答对都不是模板自动生成的,而是围绕临床诊断中的真实关切展开:从"有无异常"到"异常在哪"、从"有多严重"到"该不该手术",层层递进。
质检环节是这套数据最核心的护城河。10 位骨科专家对所有问答对进行独立校验,并统计了评分者间一致性——这是衡量标注质量的关键指标。结果显示,问题的 Cohen’s Kappa 达到 0.96、答案的 Cohen’s Kappa 达到 0.93。Kappa 值越接近 1 表示专家们越"口径一致",0.96 / 0.93 的水平已经远高于 0.8 的"几乎完全一致"门槛。
这种"开放式问答 + 多专家校验 + 高一致性"的组合,恰恰是专业数据集建设与"自动生成粗标"的本质区别:标签不仅要多,更要可追溯、可信任。团队将全部数据开源,为社区提供了一个可以放心在其上训练、评测的基准底座。
数据说话:15 款多模态大模型究竟答得怎么样?
有了高质量基准,最值得关注的就是"现在的模型到底行不行"。团队一口气评测了 15 款主流的多模态大语言模型(MLLM,Multimodal Large Language Model),既包括 Claude Sonnet、GPT-o4 mini、Gemini Flash 等闭源旗舰,也包括一批医学专用和通用开源模型。
结果耐人寻味。一方面,这些模型在语义对齐上表现"中等"——中位相似度约为 0.72,说明它们大致能说出与标准答案相关的内容;但另一方面,细致分析暴露出一个共性短板:模型普遍抓不住关键的诊断细节,尤其在"解剖保真度"和"临床完整性"两个维度上表现不佳。
换句话说,模型往往能"沾边",却难以"说准"——要么把具体节段说错,要么漏掉医生认为必须交代的临床要点。这组结果传递出一个清晰的信号:通用大模型的强大,并不能自动转化为脊柱影像解读的可靠能力。脊柱 VQA 需要专门的数据、专门的评测,乃至专门训练的模型,而这正是 SpineXR-VQA 存在的意义。
| 对比维度 | SpineXR-VQA 的做法 | 传统分类式数据集的局限 |
|---|---|---|
| 问答形式 | 开放式问答(8272 对) | 多为固定选项分类 |
| 临床维度 | 6 类(异常/严重度/位置/诊断/治疗/推理) | 通常仅"有病/无病" |
| 标注质量 | 10 位专家校验,Kappa 0.96/0.93 | 单一标注或自动标签 |
| 评测对象 | 15 款 MLLM | 单一或少量模型 |
应用前景与局限
SpineXR-VQA 的价值,首先体现在它为一度"无标可依"的脊柱 AI 问答提供了一个公平、可信的公共参照系:任何新提出的脊柱 VQA 模型,都可以在这个基准上直接跑分、横向对比,推动良性竞争。
它也更贴近真实临床。因为问答是开放式的、覆盖六类维度,研究者可以用它训练出"不仅能识病、更能讲清病"的辅助模型,未来有望成为骨科医生读片时的结构化第二意见,甚至服务于基层与远程会诊。
当然,局限同样要正视。其一,数据集以 X 光单模态为主,尚未覆盖 CT、MRI 等脊柱诊断同样依赖的影像;其二,样本规模(2187 张)相对有限,且标注专家主要来自印度与泰国,在不同人群、不同设备上的泛化能力仍需验证;其三,当前评测显示模型仍难胜任临床级解读,距离真正替代或辅助医生还有相当距离。
结论
SpineXR-VQA 的发布,再次印证了医疗 AI 的一个朴素道理:在临床级任务面前,数据与评测标准往往比模型本身更稀缺。
2187 张脊柱 X 光、8272 个专家校验的开放式问答、六类临床维度、0.96/0.93 的高一致性标注,再加上对 15 款大模型的系统性评测——这套组合把脊柱影像问答从"无人问津"推进到了"可对比、可复现"的新阶段。当通用大模型在解剖细节上一再失分时,恰恰说明:谁能做出真正贴近临床、可信任的专业数据集,谁就握住了医学影像 AI 下一阶段的钥匙。
相关问题
医学视觉问答(VQA)数据集有什么用?
它让模型在"看懂"医学影像后,还能用自然语言回答临床问题(有无异常、严重程度、定位节段、诊断治疗等),比传统"分类式"数据集更贴近医生的真实读片逻辑,是训练和评测多模态医疗大模型的关键资源。
医疗AI训练数据怎么获取?
SpineXR-VQA 这类数据集通过论文随附的公开仓库开源,可直接获取用于研究;若要做临床级落地,通常还需补充本中心、多模态的针对性数据,并经过专家校验以保证标签可追溯、可信任。
医疗数据标注怎么做?
高质量医疗数据标注的关键在"专家校验 + 一致性"。SpineXR-VQA 由 10 位骨科专家独立校验,问题与答案的 Cohen’s Kappa 分别达 0.96 与 0.93——这种可量化的标注一致性,是区分专业标注与"自动粗标"的硬指标。
| 论文标题 | SpineXR-VQA: A Clinically-Validated Visual Question Answering Dataset for Spine X-Rays(面向脊柱 X 光片的临床校验视觉问答数据集) |
| 作者 | Deepali Mishra、Sorayouth Chumnanvej、Vikas Trivedi、Ashutosh Modi、Chaklam Silpasuwanchai |
| 机构 | 泰国亚洲理工学院(AIT)、印度理工学院坎普尔分校(IIT Kanpur)联合团队;印度与泰国临床骨科专家 |
| 期刊 | ACM Transactions on Computing for Healthcare |
| 发表时间 | 2026 年 5 月 21 日录用,2026 年 9 月 3 日在线发表 |
| DOI | 10.1145/3820903 |
| PubMed | 未收录 PubMed(ACM Digital Library 收录) |
论文原文信息地址:https://www.simodata.cn/blog/2026-09-18-spinexr-vqa/
参考文献
- Mishra D, Chumnanvej S, Trivedi V, et al. SpineXR-VQA: A Clinically-Validated Visual Question Answering Dataset for Spine X-Rays. ACM Transactions on Computing for Healthcare, 2026. DOI: 10.1145/3820903
- Nguyen HT, Pham HH, Nguyen NT, et al. VinDr-SpineXR: A Deep Learning Framework for Spinal Lesions Detection and Classification from Radiographs. In Medical Image Computing and Computer Assisted Intervention (MICCAI 2021), 2021: 291–301. DOI: 10.1007/978-3-030-87240-3_28