临床研究AI为何缺数据?TrialPanorama 160万条临床试验数据集与8B模型反超70B解读
Keiji AI 联合伊利诺伊大学、美国国立卫生研究院国家医学图书馆与爱丁堡大学,在 Nature 旗下期刊 npj Digital Medicine 发布结构化医疗数据资源 TrialPanorama,聚合 15 个全球注册库约 160 万条临床试验记录,构建 152,000 条训练与测试样本、覆盖 8 类临床研究任务,训练出的 8B 领域模型在全部任务上反超 70B 通用大模型,为医疗AI训练数据与临床研究智能化提供可复现的开放数据底座。
研究背景:临床研究AI为什么一直"缺数据、难落地"?
人工智能在临床研究中的应用前景一直被看好:从文献检索、系统综述,到试验方案设计、样本量估算,这些高度依赖专业知识与经验的工作,理论上都能由大语言模型(Large Language Model,LLM)来辅助甚至接手。
但现实是,通用大模型在临床研究场景里往往"中看不中用"。原因很直接:临床试验的数据总量虽然庞大,却散落在全球十几个注册库、PubMed 文献、Cochrane 系统综述等彼此割裂的源头里,没有统一的字段结构,也没有标准化的实体关联。模型要么检索不到,要么抓不到关键信息,更谈不上支撑证据综合与方案设计这类高门槛任务。
这就带来一个长期痛点:做临床研究 AI,最缺的不是模型,而是一份结构化的、可训练、可评测的医疗数据集。没有它,“AI 辅助临床研究"就只能在演示里打转。
创新点:TrialPanorama 如何把散落的临床试验变成结构化医疗数据?
2026 年 7 月,Keiji AI 联合伊利诺伊大学厄巴纳-香槟分校(UIUC)、美国国立卫生研究院国家医学图书馆(NLM)与爱丁堡大学的研究团队,在 Nature 旗下期刊 npj Digital Medicine 上发布了 TrialPanorama——一个面向临床研究 AI 的大规模结构化资源。
它的核心是把"散落"变"统一”,可以概括为三点:
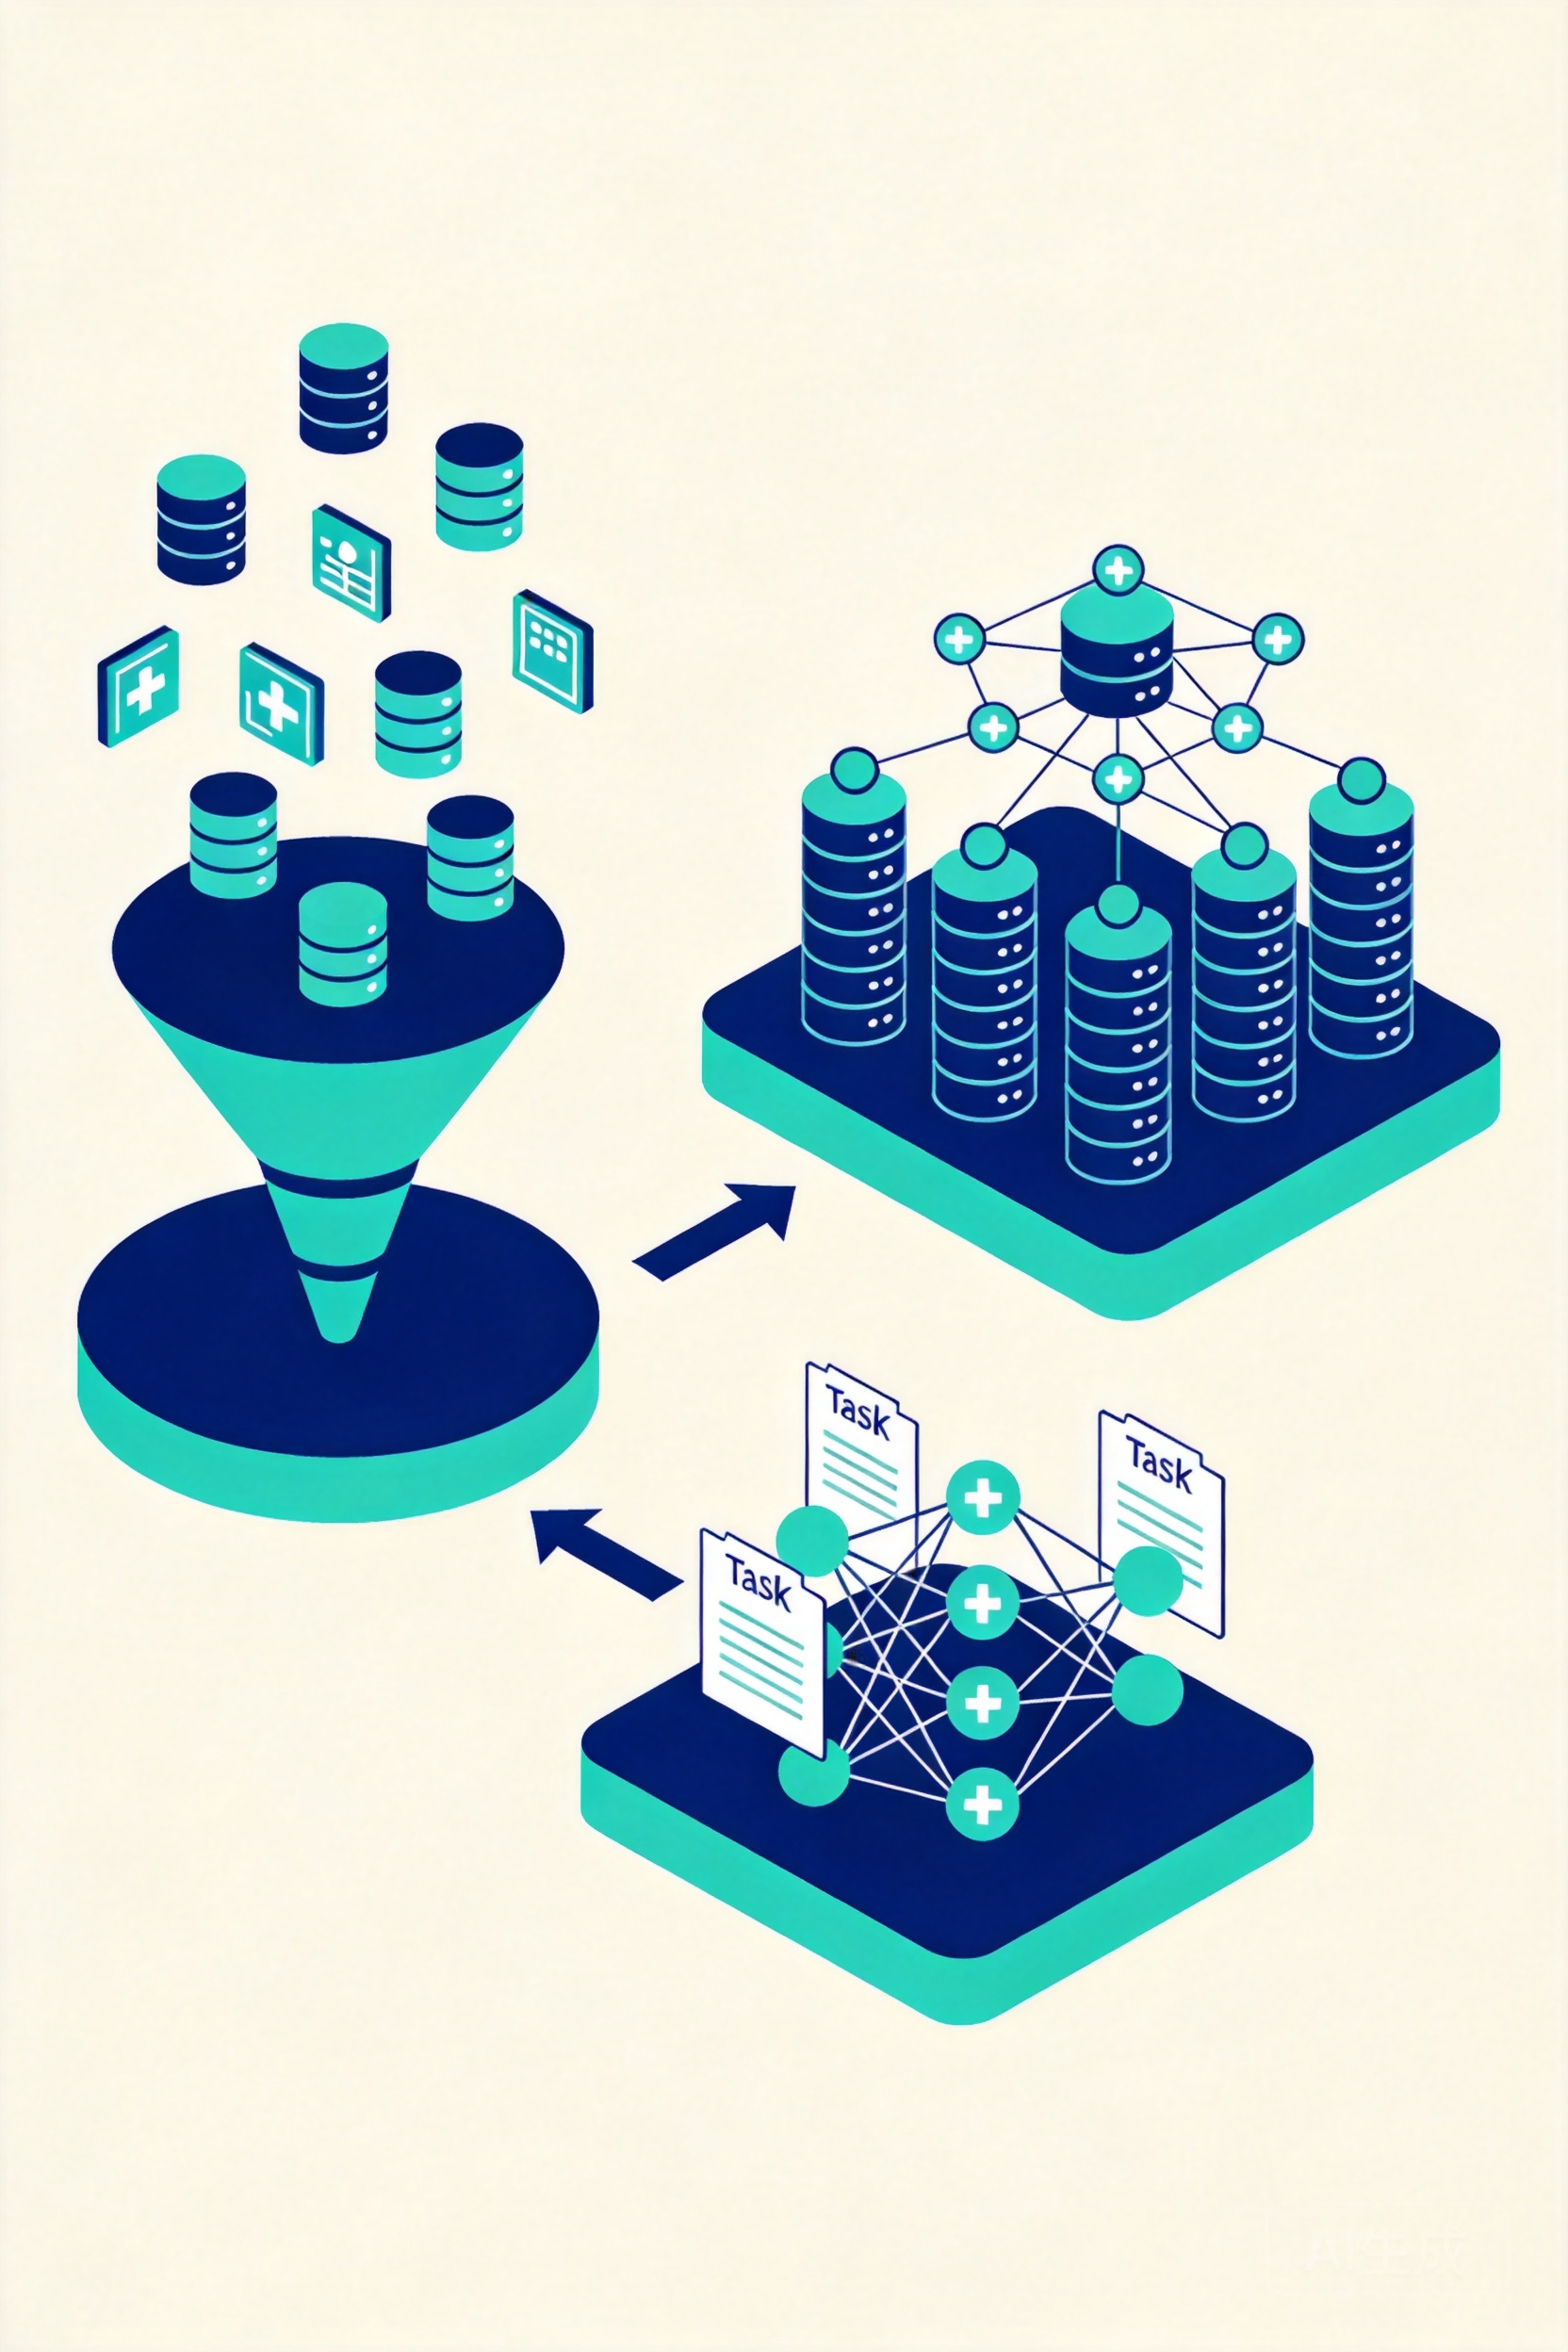
- 数据聚合:整合 约 160 万条临床试验记录,来自 ClinicalTrials.gov、WHO 国际临床试验注册平台(ICTRP)、欧盟注册库等 15 个全球注册源,并关联 PubMed 文献与生物医学本体。
- 结构化与知识图谱:把试验的干预、疾病、生物标志物、终点、不良事件、结果等属性,统一映射到 DrugBank、MedDRA 等标准本体,组织成关系数据库与知识图谱。
- 任务化基准:从数据中构建出 152,000 条训练与测试样本,覆盖 8 类关键临床研究任务,让"数据"直接变成"可训练、可评测"的题。
换句话说,TrialPanorama 不是又收集一批文档,而是把临床研发里最值钱的结构化知识,做成了一份可计算的医疗数据资产。
数据集构建方法:从15个注册库到8类任务的清洗与质控
TrialPanorama 的构建是一套清晰的数据工程流程,难点在于"对齐"。
在数据源层,团队把 15 个全球注册库的记录去重、合并,并通过共享的药物、疾病、生物标志物等关系,把试验与论文、系统综述连接起来。据公开核读,约 48.7% 的记录来自 PubMed、31.6% 来自 ClinicalTrials.gov,其余来自其他注册库——这也提醒我们,“160 万条记录"不等于"160 万项彼此独立的试验”。
在任务层,8 类任务被分成两组:
- 系统综述流程(3 项):研究检索、研究筛选、证据总结。
- 试验设计与优化(5 项):分组(臂)设计、入排标准设计、终点选择、样本量估算、试验完成度评估与终止原因解释。
质控上,最新数据被严格划分为测试集以防数据泄漏;训练采用"指令—输入—答案"三元组格式,先做两阶段监督微调,再对可验证任务(如研究检索、样本量估算)引入带可验证奖励的强化学习(RL),让模型在"能否召回目标文献"“是否贴近历史入组数"这类可计算反馈上迭代。
数据说话:8B小模型凭什么反超70B大模型?
团队用 TrialPanorama 训练了一个 80 亿参数(8B)的领域模型(基于 Qwen3-8B 与 Llama3-8B),并与 Llama3-70B、GPT-4o 等通用大模型正面比较,结果颇具冲击力。
核心结论是:这个 8B 小模型在全部 8 类任务上都超过了 70B 的通用大模型,相对提升从 5.2% 到 73.7% 不等。
具体到关键任务:
| 任务类型 | 8B 领域模型表现 | 通用模型对比 |
|---|---|---|
| 研究检索 Recall@500 | 约 54%–57% | GPT-4o 约 47% |
| 分组设计准确率 | 最高 90.0% | 通用 85%–89% |
| 样本量估算误差(MAE) | 356–394 人 | GPT-4o 约 452 人 |
| 完成/终止判断平衡准确率 | 72.8%–74.3% | GPT-4o 59.3% |
这一结果传递了一个清晰的信号:在垂直领域,高质量、任务对齐的数据加上针对性后训练,往往比单纯堆模型参数更有效。数据规模不决定一切,但"数据对不对路"几乎决定一切。
应用前景与局限
TrialPanorama 最现实的落地形态,不是让 AI 直接签发一份完整试验方案,而是成为一个可追溯的"设计副驾驶”:根据研究问题检索相似试验与综述、为分组/入排标准/终点提供带来源的候选、提示历史样本量与终止风险,供医学与统计专家决策参考。
它的局限同样明确:
- 覆盖不均:不同国家、不同病种的数据分布不均衡,来源数据质量参差。
- 学的是历史而非最优:模型复现的是历史决策模式,可能把旧标准、偏差与登记噪声一起学进去。
- 关键决策仍不可替代:终止原因解释准确率仅约 26%–31%,样本量估算也需统计师基于当前问题复核。论文作者反复强调,这类系统应辅助而非替代人类专家,警惕自动化偏差。
结论
TrialPanorama 的价值,不在于"AI 已经会设计临床试验",而在于它证明了另一件同样重要的事:当试验注册、论文、系统综述被组织成一份结构化的医疗数据集后,一个 8B 小模型就能更有效地识别与复现临床研究中的历史决策模式。
160 万条记录、15 个注册源、8 类任务、8B 反超 70B——这套组合把"临床研究 AI 缺数据"的老问题,往前推进到了"数据可训练、模型可对比、结果可复现"的新阶段。对行业而言,模型可以随时更换,但经过治理、关联与版本管理的医疗数据资产,才是更难被替代的护城河。
相关问题
医疗AI训练数据怎么获取?
对临床研究 AI 而言,最直接的途径就是使用 TrialPanorama 这类公开的结构化资源。研究团队已把数据库、基准样本与模型全部开源到 Hugging Face 与 GitHub,科研与产业团队均可直接获取并复现;ClinicalTrials.gov、ICTRP 等注册库本身也是可公开抓取的一手数据源。
结构化医疗数据和普通文本数据有什么区别?
普通文本是"自然语言段落",机器难以直接计算;结构化医疗数据则是把干预、疾病、终点、结果等属性抽取成标准化字段并关联到本体,能让模型像查数据库一样精准调用,这也是 TrialPanorama 能训练出 8B 反超 70B 的关键。
这套数据集适合直接做临床试验方案设计吗?
可以辅助,但不能替代。它能快速检索相似试验、生成分组/入排标准/终点候选、给出样本量与终止风险参照,但最终的科学问题、估计目标与统计方法仍需医学与统计专家把关。
| 论文标题 | Benchmarking and Developing Large Language Models Using One Million Clinical Trials(用一百万项临床试验对大型语言模型进行基准评测与开发) |
| 作者 | Zifeng Wang、Jiacheng Lin、Qiao Jin、Junyi Gao、Jathurshan Pradeepkumar、Pengcheng Jiang、Benjamin Danek、Zhiyong Lu、Jimeng Sun |
| 机构 | Keiji AI、伊利诺伊大学厄巴纳-香槟分校(UIUC)、美国国立卫生研究院国家医学图书馆(NLM/NIH)、爱丁堡大学 |
| 期刊 | npj Digital Medicine(Nature Publishing Group) |
| 发表时间 | 2026 年 7 月 31 日 |
| DOI | 10.1038/s41746-026-02933-7 |
论文原文信息地址:https://www.simodata.cn/blog/2026-09-21-trialpanorama/
参考文献
- Wang Z, Lin J, Jin Q, et al. Benchmarking and developing large language models using one million clinical trials. npj Digital Medicine, 2026. DOI: 10.1038/s41746-026-02933-7