医疗数据标注怎么防住隐藏偏倚?G-AUDIT 跨模态数据集审计框架解读
约翰霍普金斯大学联合美国 FDA 在 Nature 旗下期刊 npj Digital Medicine 发布 G-AUDIT 数据集审计框架,通过属性效用与可检测性两个维度自动量化医疗 AI 训练数据中的捷径学习风险,成功识别传统定性方法容易忽略的隐藏偏倚,为医疗数据标注与数据集质控提供训练前把关工具。
研究背景:医疗AI为什么会"聪明汉斯"式翻车?
20 世纪初,一匹叫"汉斯"的马因为会"算数"而名噪一时——它能用马蹄敲出正确答案。后来人们发现,汉斯根本不会算数,它只是在读驯马师无意识的身体语言,据此判断该敲几下。
今天,很多医疗人工智能(AI)模型也会犯同样的毛病,被称为**“聪明汉斯现象”(Clever Hans phenomenon)。研究团队举了个例子:一个靠眼睛照片预测性别的模型准确率很高,事后却发现它靠的不是任何生物学特征,而是照片里的睫毛膏**。
问题出在基于关联的学习。当训练数据不能代表模型未来要面对的临床场景时,与任务无关的元数据就会"冒充"临床信号——模型在开发数据上表现亮眼,一到真实世界就失灵。更麻烦的是,这类偏倚在测试阶段还会被隐藏起来,因为测试集往往和训练集来自同一个"有偏"的来源。
创新点:G-AUDIT 如何把审计从"事后"搬到"事前"?
过去大家审计医疗 AI,多是看模型训练完之后的表现;但"表现好"不等于"学对了"。约翰霍普金斯大学(Johns Hopkins University)与美国食品药品监督管理局(FDA)器械与放射健康中心(CDRH)联合团队,在 npj Digital Medicine 上提出了一套新工具:G-AUDIT(Generalized Attribute Utility and Detectability-Induced bias Testing,广义属性效用与可检测性诱导偏倚测试)。
它的思路一句话就能说清:不审模型,审数据本身。在训练开始之前,先扫描数据集里每条元数据,量化它会不会把模型"带偏"。
G-AUDIT 有两个最突出的特点:
- 模态无关(modality-agnostic):不挑数据格式,医学影像、临床文本、表格数据都能审。
- 自动量化:把"这个属性有没有风险"从主观判断变成可计算的分数,并给出风险排序。
数据集构建方法:属性效用与可检测性怎么算?
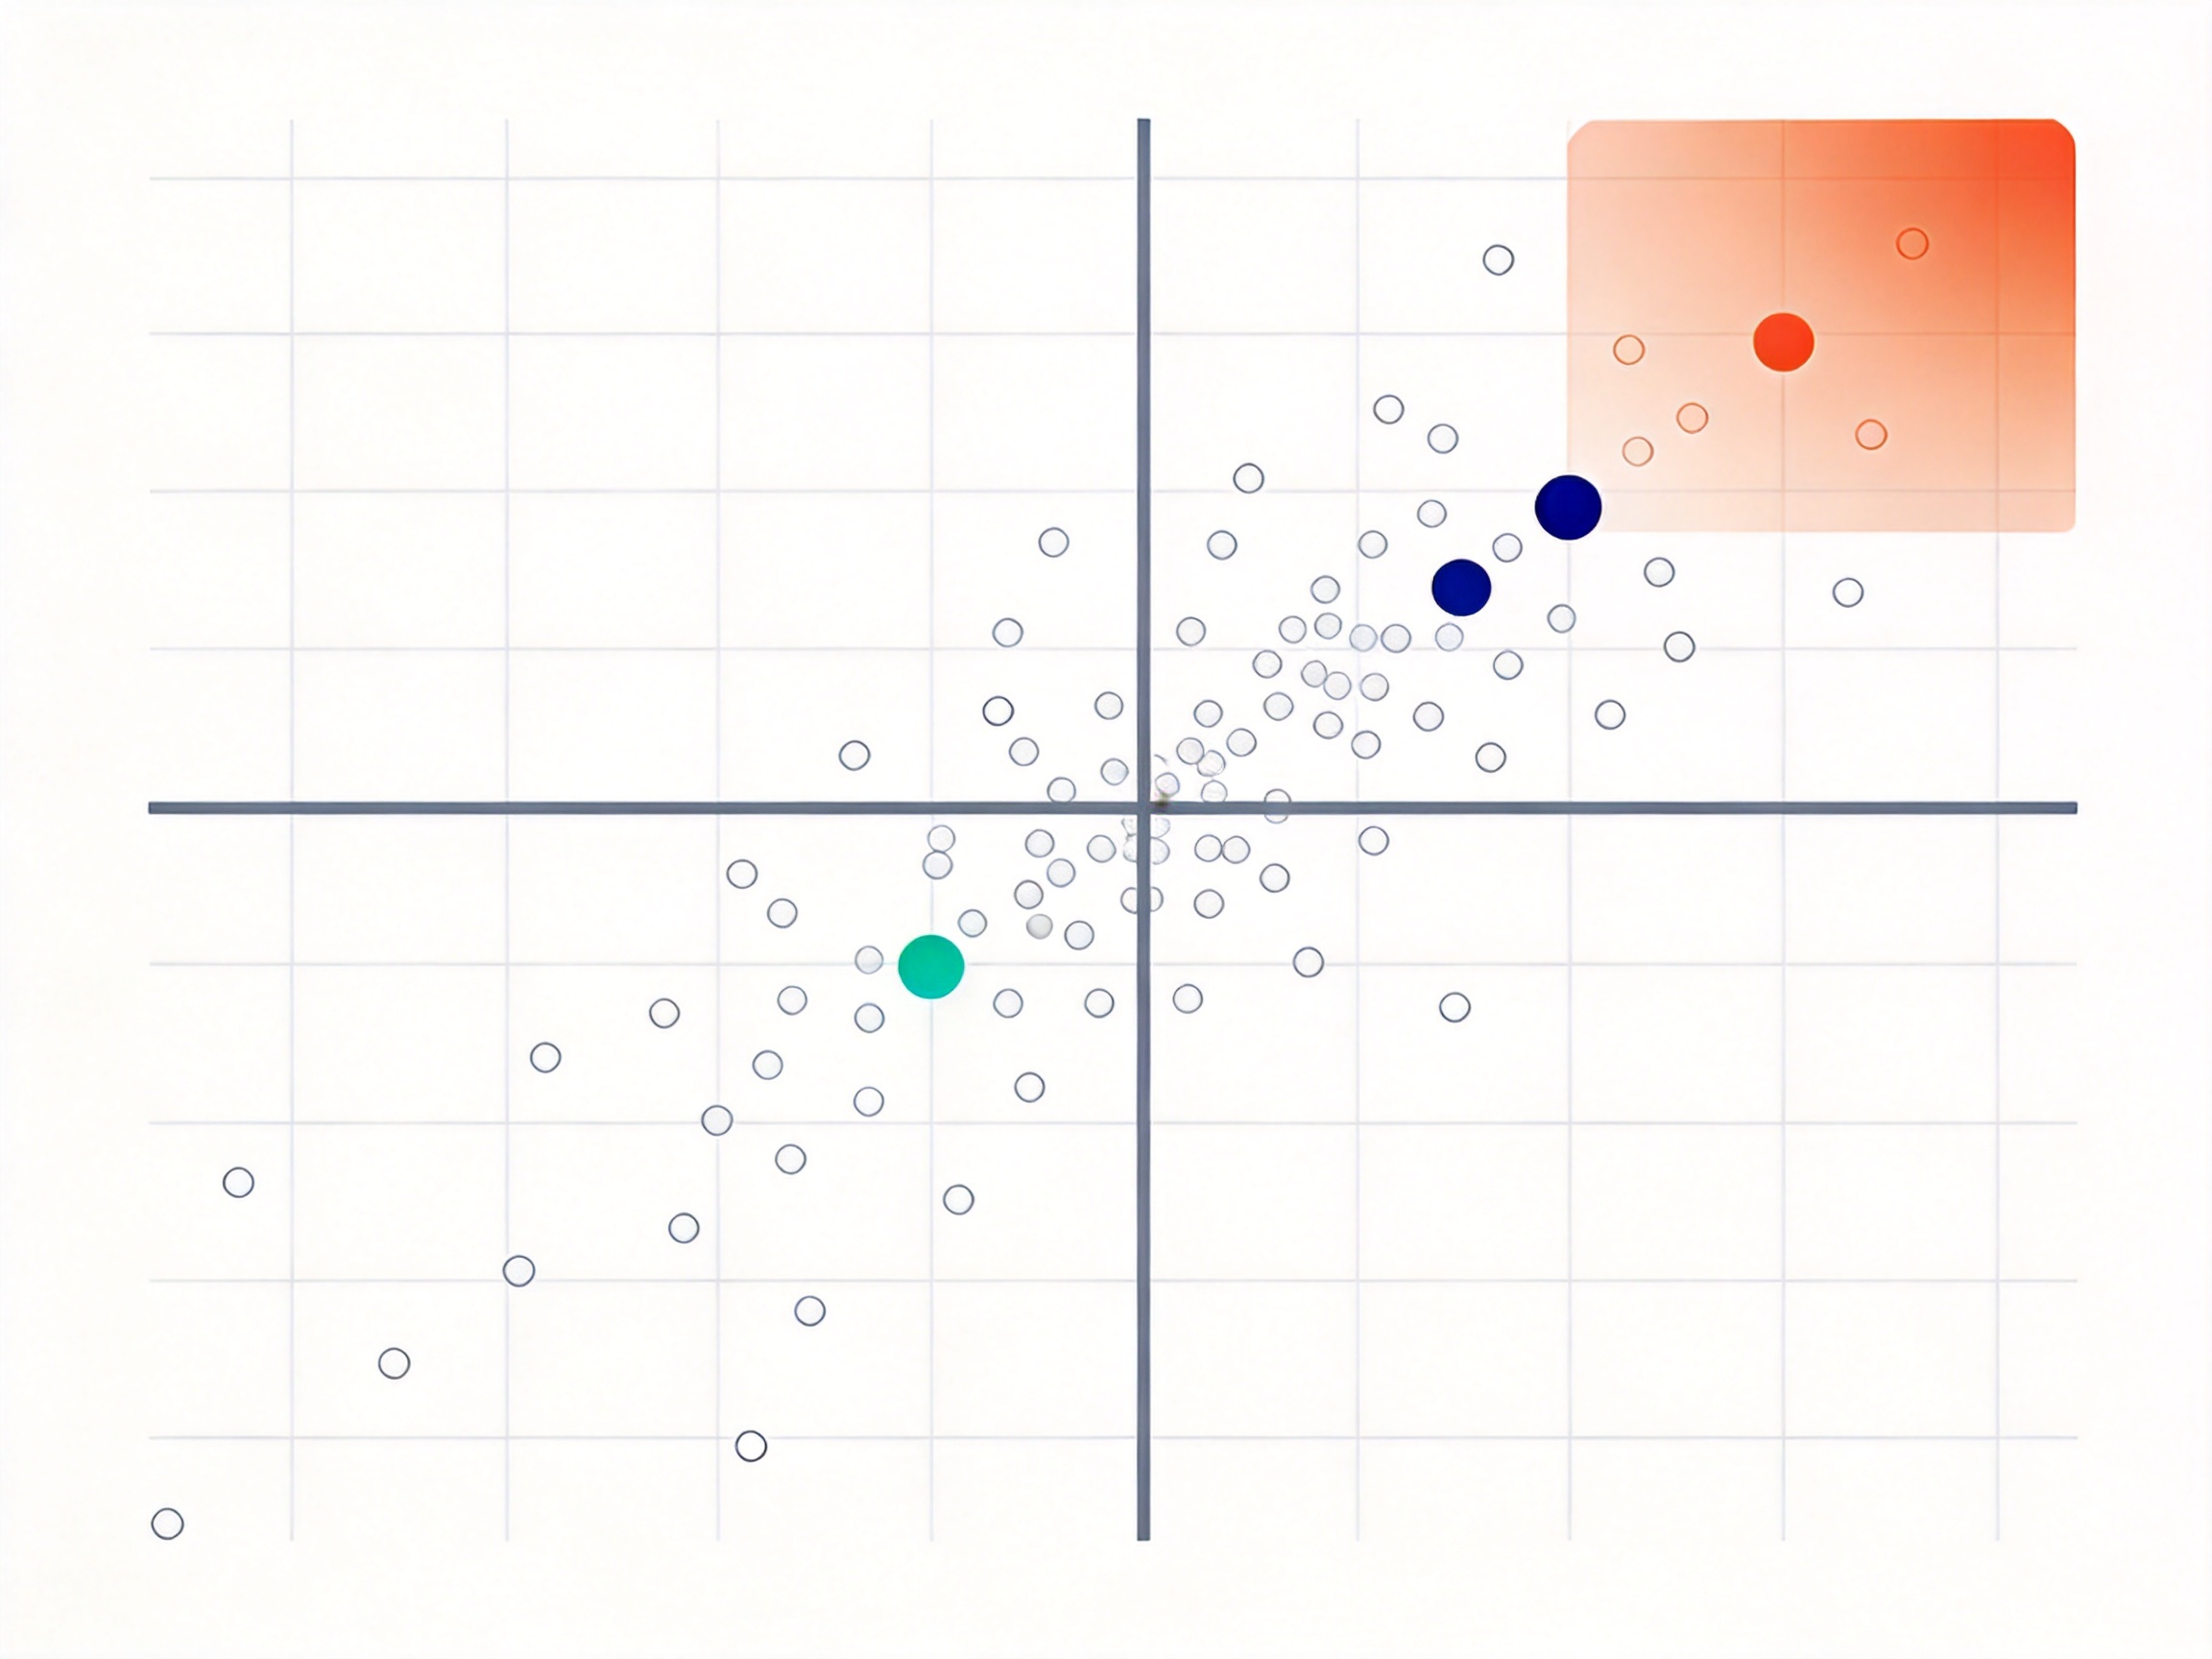
G-AUDIT 的核心是同时考察一个属性的两个维度,并把它们画成一张散点图:
- 属性效用(Utility):这个属性对预测任务标签到底"有没有用"——比如"相机质量"是否真的能预测"是不是癌症"。
- 可检测性(Detectability):模型能不能从数据里"复原"出这个属性——也就是模型实际能不能学到它。
判断逻辑很直接:效用高 + 可检测性高 = 危险捷径。一个属性如果既与标签强相关、又很容易被模型学到,那模型大概率会走这条"近路",而不是去学真正有临床意义的特征。
团队还做了两类稳健性检验:一是切换因果 / 反因果假设,二是更换用来估计可检测性的代理模型架构。结果显示,尽管可检测性的绝对值会变,但属性的相对风险排名保持稳健,说明这套方法不依赖某个特定模型设定。
数据说话:三个模态、三项任务查出了什么?
团队在三种数据模态、三项任务上验证了 G-AUDIT,覆盖了医疗 AI 最常见的场景:
| 数据模态 | 任务 | 查出的典型捷径 |
|---|---|---|
| 医学影像 | 皮肤病变分类(ISIC 2019) | 相机质量、照片里的标尺 |
| 临床文本 | 电子病历污名化语言检测 | 合规性、外表举止等属性 |
| 表格数据 | ICU 死亡率预测(MIMIC-III) | 大量"缺失值"本身 |
在皮肤病变分类(ISIC 2019)上,团队发现专科癌症诊所(收治高危人群)与普通皮肤科诊所(癌症更少)的成像设备质量不同,且癌症诊所更常在照片里放标尺来跟踪病灶大小。于是模型可能学会"相机质量"或"有标尺 = 癌症"。
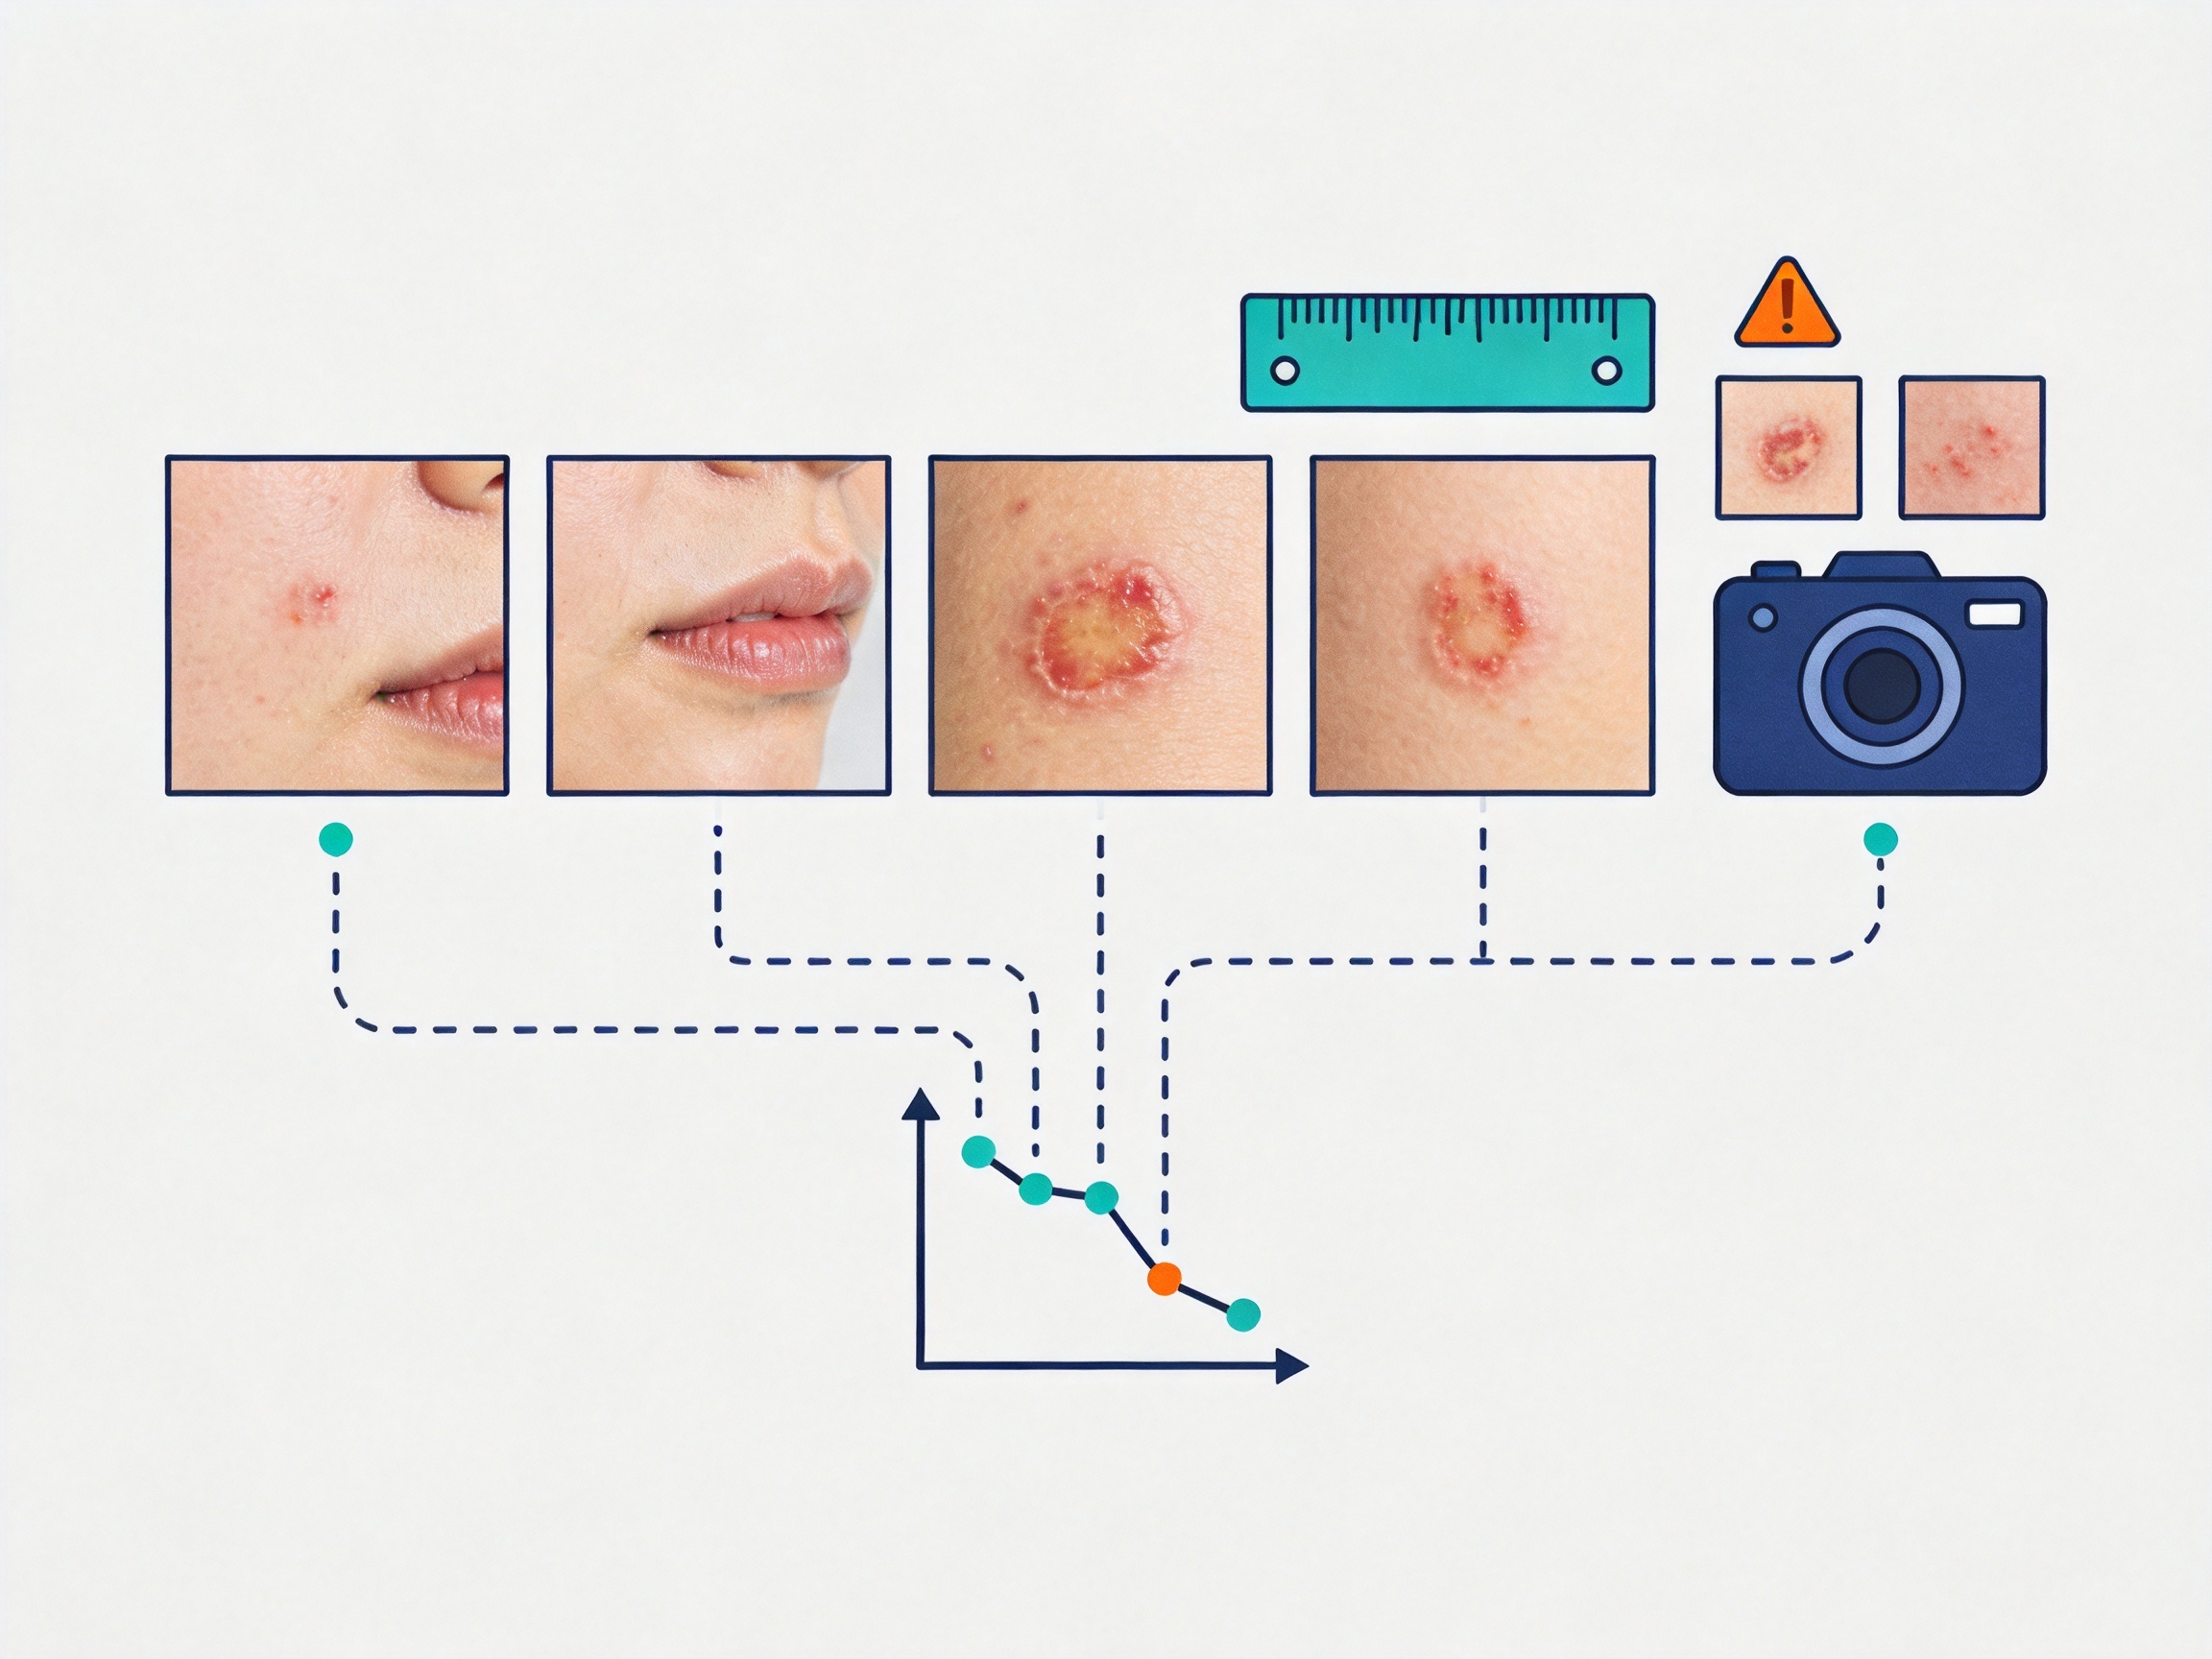
作者给出了一个非常直观的量化结论:在被检出的高风险属性上,最坏情况下模型 AUC 会下降约 0.2。可别小看这 0.2——把它放到真实世界,就是用手机相机(没有标尺、相机质量与癌症无关)拍片时,模型学到了"标尺"和"相机",凭空制造出健康不公平。
另一个更隐蔽的发现来自 ICU 死亡率预测:大部分最可检测的潜在捷径,竟然是"缺失值"本身——数据里"缺了什么"反而成了模型判断的信号,这比明显的图像伪影更难靠肉眼发现。
应用前景与局限
G-AUDIT 最有价值的落点,是把它前置到医疗数据标注与数据集质控环节,成为数据上线前的"体检":
- 标注与采集阶段:在数据入库前就提示哪些采集属性、标注习惯可能带来偏倚。
- 监管与审计:为 FDA 这类监管机构评估数据集质量提供一个可量化、可复现的抓手。
- 跨模态复用:一套方法通吃影像、文本、表格,降低团队为不同模态各写一套审计逻辑的成本。
局限同样要讲清楚:
- 量化"风险"不等于证明"因果":G-AUDIT 给出的是相对风险排序,提示"这里可能有问题",最终仍需领域专家结合临床背景判断。
- 依赖元数据的完整记录:如果采集时根本没记录相机型号、诊所类型等属性,工具也无从审计——这对数据治理提出了更高要求。
- 暂未覆盖所有偏倚类型:它聚焦"捷径学习"这一种机制,选择偏倚、标签噪声等其他问题仍需配合其他手段。
结论
G-AUDIT 的意义,不在于它"抓出"了多少个具体坏属性,而在于把医疗数据集审计这件事,从模型训练后的"事后补救",前移到了数据标注与采集阶段的"事前把关"。
它用两个可计算的维度——效用与可检测性——把"这个数据会不会带偏模型"从一句口号变成一份可复现的风险清单。对行业而言,模型可以不断换新,但一份经过偏倚审计、可追溯的医疗数据资产,才是更难被替代的底座。
相关问题
医疗数据标注怎么做才不容易引入偏倚?
关键是让采集与标注的元数据"留痕":记录成像设备、采集机构、人群构成、标注者习惯等属性,再用 G-AUDIT 这类工具在训练前扫描这些属性与标签的关联,优先处理"效用高且可检测"的高风险捷径,而不是等模型翻车后再回头查。
这套审计工具只适用于医学影像吗?
不是。G-AUDIT 是模态无关的,论文里就在医学影像(皮肤病变分类)、临床文本(电子病历污名化语言检测)、表格数据(ICU 死亡率预测)三模态上都做了验证,因此影像、文本、结构化数据都能用。
模型在测试集上表现好,就说明数据没问题吗?
不一定。这正是 G-AUDIT 想提醒的:如果训练集和测试集来自同一个有偏来源,偏倚会在测试阶段被"隐藏"。看起来漂亮的表现,可能只是模型学会了相机质量、标尺这类与临床无关的捷径,一到真实场景就失效。
| 论文标题 | Detecting dataset bias in medical AI using a generalized and modality agnostic auditing approach(使用一种通用且不受模态限制的审计方法检测医疗AI中的数据集偏倚) |
| 作者 | Nathan Drenkow、Mitchell Pavlak、Keith Harrigian、Ayah Zirikly、Adarsh Subbaswamy、Mohammad Mehdi Farhangi、Nicholas Petrick、Mathias Unberath |
| 机构 | 约翰霍普金斯大学、约翰霍普金斯大学应用物理实验室(APL)、乔治华盛顿大学、美国食品药品监督管理局器械与放射健康中心(FDA/CDRH) |
| 期刊 | npj Digital Medicine(Nature Portfolio) |
| 发表时间 | 2026 年 5 月 29 日(第 9 卷) |
| DOI | 10.1038/s41746-026-02807-y |
| PubMed | PMID 42215678 |
论文原文信息地址:https://www.simodata.cn/blog/2026-09-23-g-audit/
参考文献
- Drenkow N, Pavlak M, Harrigian K, et al. Detecting dataset bias in medical AI using a generalized and modality agnostic auditing approach. npj Digital Medicine, 2026, 9(1). DOI: 10.1038/s41746-026-02807-y