医学影像数据集如何支撑 3D 影像大模型?斯坦福 Merlin 腹部CT数据集构建与开放解读
斯坦福大学团队在 Nature 发表首个原生 3D 腹部CT视觉语言基础模型 Merlin,同时开源 25494 例腹部CT与放射报告配对数据集。模型融合结构化电子病历诊断代码与非结构化放射报告作为监督信号,覆盖 752 项诊断与预后任务,揭示医学影像数据集从单模态标注走向多模态自监督的新路径。
研究背景:3D 影像大模型为什么普遍"瘸腿"?
医学影像里,腹部计算机断层扫描(CT)是最常见、也最难自动解读的检查之一。一份腹部 CT 往往包含上百张轴位切片,放射科医生要同时看多个器官、血管,还要留意检查之外的"偶发发现",一份扫描解读下来最多要花约 20 分钟。
但过去两年主流的医学视觉语言模型(Vision-Language Model,VLM),绝大多数只处理二维图像和短文本——它们擅长看 X 光片、看单张切片,却很难真正"读懂"一整个三维体数据。要么把 CT 拍平成一张张切片逐个处理,要么处理完再把切片级结果拼起来,空间关系被切断了。
更根本的瓶颈在医学影像数据集:公开的、带报告的高质量腹部 CT 数据集长期空白,导致三维 VLM 想训练都没数据可用。这正是斯坦福大学团队要解决的核心痛点。
创新点:Merlin 如何用"现成的临床数据"训练 3D 影像大模型?
斯坦福大学医学与影像人工智能中心(AIMI)的 Akshay Chaudhari 团队,在 Nature 上提出了Merlin——首个针对腹部 CT 的原生三维视觉语言基础模型。
它的核心思路一句话就能说清:医院里现成的数据,本身就是最好的监督信号,根本不用额外人工标注。
- 原生 3D:直接处理整个 CT 体数据,而不是降维成 2D 切片,保留了器官在三个空间维度上的解剖关系。
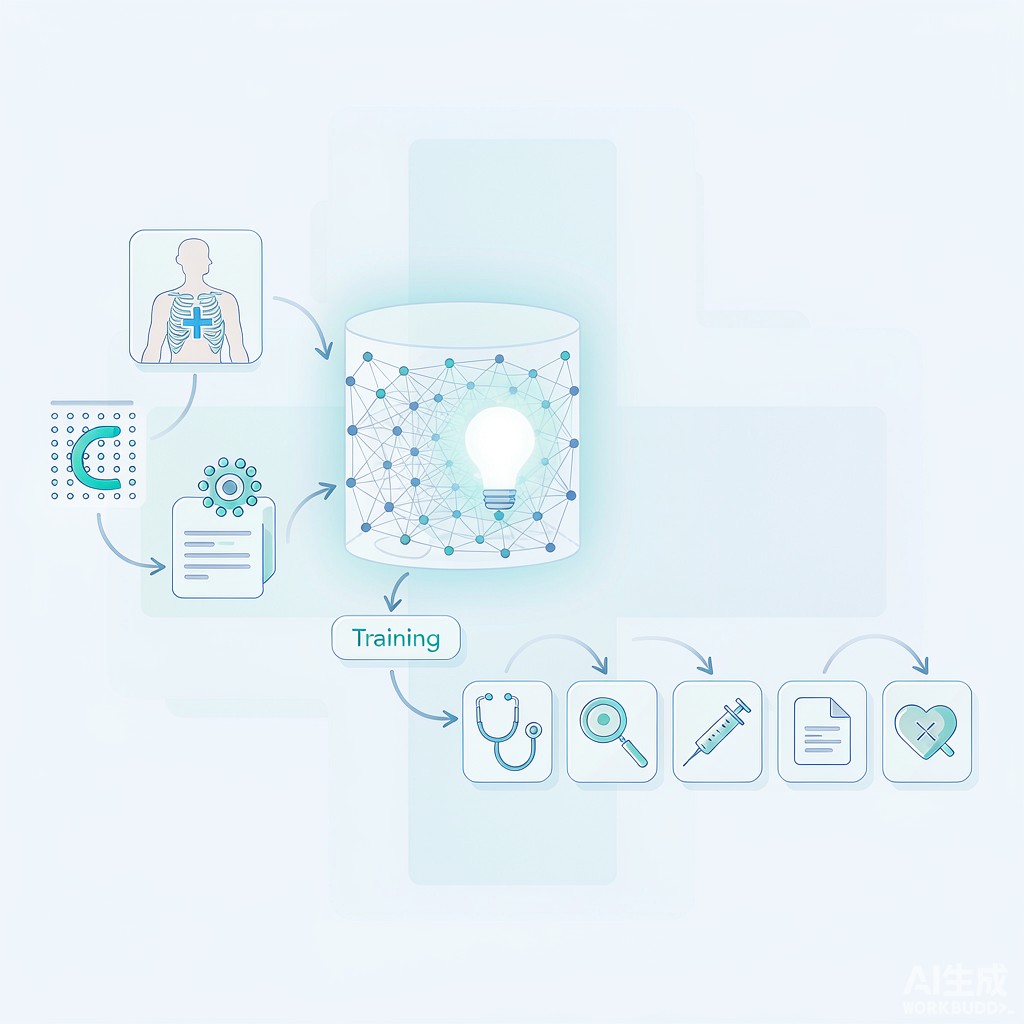
- 三路数据自监督:把配对好的 CT 扫描、电子健康记录(EHR)里的诊断代码、以及放射科医生手写的报告,一起喂给模型学习。
- 多阶段预训练:用分阶段的训练框架把这三种异构信号揉合在一起,整个过程不依赖任何额外的人工标注。
数据集构建方法:2.5 万例腹部CT+报告是怎么搭起来的?
Merlin 背后是一套精心整理的高质量临床数据集,它同时融合了结构化医疗数据和非结构化报告:
- CT 扫描:来自真实医疗中心的合规全腹部 CT 检查,每份取轴位切片最多的序列以最大化信息量,从 25,528 次扫描中整理出 10,628,509 张二维图像(对应 15,331 例 CT)。
- 结构化 EHR:配套超过 180 万个诊断代码,为模型提供机器可读的"标签"。
- 放射报告:超过 600 万 token;其中训练只用报告的 findings(所见) 部分,共约 1,005 万 token,因为这一部分对各器官系统的观察最细致。
更难得的是,团队把这套数据开源了:对外发布 25,494 对腹部 CT 扫描与放射报告,覆盖 18,317 名患者。这填补了"公开腹部 CT 数据集用于三维 VLM 训练与评估"的长期空白,其他研究者可以拿它做复现和二次开发。
数据说话:752 项任务全面领先,报告生成仍会"漏报"
团队把 Merlin 放在 6 大类、共 752 项任务上做了全面评估:
| 任务类型 | 覆盖内容 |
|---|---|
| 零样本发现分类 | 30 种腹部 CT 发现 |
| 表型分类 | 692 种疾病表型(由诊断代码分组而来) |
| 跨模态检索 | 图像↔发现、图像↔印象 |
| 5 年慢性病预测 | 6 种慢性病 |
| 放射报告生成 | 对照 RadFM 等基线 |
| 3D 语义分割 | 20 个器官 |
在规模上,Merlin 做了内部 5,137 例扫描验证,以及外部 44,098 例扫描验证(来自 3 个独立站点和 2 个公开数据集 VerSe、TotalSegmentator),结果显示它在机构间和不同解剖部位上都保持了高泛化能力,全面优于二维 VLM、CT 基础模型和现成的放射学模型。
一个最有商业想象空间的结论是5 年慢性病预测:用全部标签训练,Merlin 对 6 种慢性病(慢性肾病、骨质疏松、心血管病、缺血性心脏病、高血压、糖尿病)的平均 AUROC 达到 0.757;即便只用 10% 标签,也仍有 0.708。这说明——为某个目的做的 CT,可能藏着另一个疾病的早期风险信号。
但论文也诚实交代了边界:在放射报告生成上,Merlin 虽然多项指标超过 RadFM,却出现了漏报——比如漏掉了人类报告里写着的胆囊结石,还编造了一个不存在的序列或切片位置。这说明基准分数漂亮,不等于临床可落地。
应用前景与局限
Merlin 的价值,不只是"又一个更强的模型",而是证明了一条医学影像数据集建设的新路径:与其花巨资逐张人工标注,不如把医院里已经存在的 CT、诊断代码、报告配成对,让模型自己学。
前景包括:
- 减轻放射科负担:辅助解读腹部 CT,缩短从扫描到诊断的时间。
- 生物标志物发现:从常规 CT 里挖出肉眼看不出的疾病风险信号。
- 风险分层:为慢性病早筛提供数据驱动的依据。
局限同样要讲清楚:
- 尚未临床部署:仍需前瞻性临床试验、监管审批和影像工作流集成,基础模型与现有系统之间还没有标准接口。
- 报告生成会漏报、编造:离"自动写报告"还有距离,复杂任务仍需医生把关。
- 外部验证数据不公开:出于患者隐私和数据使用协议,外部验证用的临床数据集未开放,外界无法完整复现每一组外部结论。
结论
Merlin 用一份 2.5 万例的腹部 CT 数据集,同时回答了"3D 影像大模型缺什么"和"缺的数据从哪里来"两个问题。
它的启示在于:医学影像数据集的价值,正在从"人工精细标注"转向"多模态自监督配对"。把结构化诊断代码、非结构化报告和影像对齐起来,医院里沉睡多年的临床数据,就能变成训练下一代影像大模型的燃料。模型可以不断迭代,但一份高质量、可复现、被开源的数据底座,才是行业最稀缺的资产。
相关问题
医学影像数据集哪里下载?
Merlin 的模型权重、代码和数据集均已公开:模型在 Hugging Face 的 StanfordMIMI/Merlin 仓库,代码在 GitHub 的 StanfordMIMI/Merlin 仓库,PyPI 上也有 merlin-vlm 包。25494 例腹部 CT 与报告配对数据集需签署数据使用协议(data-use agreement)后,通过斯坦福 AIMI 平台获取,论文的数据可用性声明里写明了具体入口。
医疗AI训练数据怎么获取?
Merlin 给出了一个可复用的答案:不依赖人工逐张标注,而是把医院现成的配对数据——CT 影像、EHR 诊断代码、放射报告——用多阶段预训练框架对齐起来自监督学习。这种方式成本低、可规模化,前提是要做好脱敏、合规和数据使用协议。
3D 影像大模型和 2D 模型到底差在哪?
2D 模型一次只看一张切片,再事后拼接,跨切片的解剖空间关系被切断;3D 模型一次处理整个体数据,能同时看多个器官、血管和偶发发现,更贴合医生的真实阅片方式,这也是 Merlin 能在 752 项任务上全面领先二维基线的关键原因。
| 论文标题 | Merlin: a computed tomography vision-language foundation model and dataset(Merlin:一个计算机断层扫描视觉语言基础模型与数据集) |
| 作者 | Louis Blankemeier、Ashwin Kumar(共同第一)、Joseph Paul Cohen、Jiaming Liu、Longchao Liu、Akshay S. Chaudhari(通讯)等 38 位作者 |
| 机构 | 斯坦福大学医学与影像人工智能中心(AIMI)、斯坦福放射学、加州大学伯克利分校、威斯康星大学麦迪逊分校、以色列爱因斯坦医院、苏黎世大学医院、长庚纪念医院、Google 等 |
| 期刊 | Nature |
| 发表时间 | 2026 年 3 月 4 日 |
| DOI | 10.1038/s41586-026-10181-8 |
| PubMed | PMID 41781626 |
论文原文信息地址:https://www.simodata.cn/blog/2026-09-25-merlin-abdominal-ct/
参考文献
- Blankemeier L, Kumar A, Cohen JP, Liu J, Liu L, Van Veen D, et al. Merlin: a computed tomography vision-language foundation model and dataset. Nature, 2026. DOI: 10.1038/s41586-026-10181-8