多模态心电数据集如何打破数据孤岛?MEETI 开源基准的“信号+图像+文本”四位一体构建解读
北京大学团队在 Scientific Data 发布首个大规模心电全模态对齐开源数据集 MEETI,基于 MIMIC-IV-ECG 的 80 余万份 12 导联记录二次开发,把原始波形、绘制图像、逐拍参数与 LLM 生成的文本解释四位一体对齐,为可解释的多模态心血管 AI 提供了可复现基准。
研究背景:心电 AI 为什么卡在“数据孤岛”?
心血管疾病是全球第一大死因,每年导致超过 1700 万人死亡。心电图(Electrocardiogram,ECG)是评估心脏电生理活动最基础、最无创的手段,对诊断心律失常、心肌缺血和传导障碍不可或缺。
但一个矛盾长期存在:深度学习在心电波形识别上已经能达到“专家级”水平,可临床真正可用的多模态心电 AI 却迟迟落不了地。根子不在算法,而在数据——公开的心电数据集大多是单模态的,最多只做到“信号 + 文本”两两配对。
更棘手的是,现有大语言模型(LLM)根本没法直接处理心电波形:心电信号有时序动态和幅度变化,本质是时间序列,跟图像的空间模式完全不同。想训练一个既能“看懂波形”、又能结合图像和文本做推理的心电大模型,市面上几乎没有现成的开源医学数据集可用。
创新点:MEETI 如何把信号、图像、文本、参数“四位一体”对齐?
北京大学健康医疗大数据国家研究院洪申达团队,在 Scientific Data 上发布了 MEETI(MIMIC-IV-Ext ECG-Text-Image)——首个大规模心电全模态对齐开源数据集。
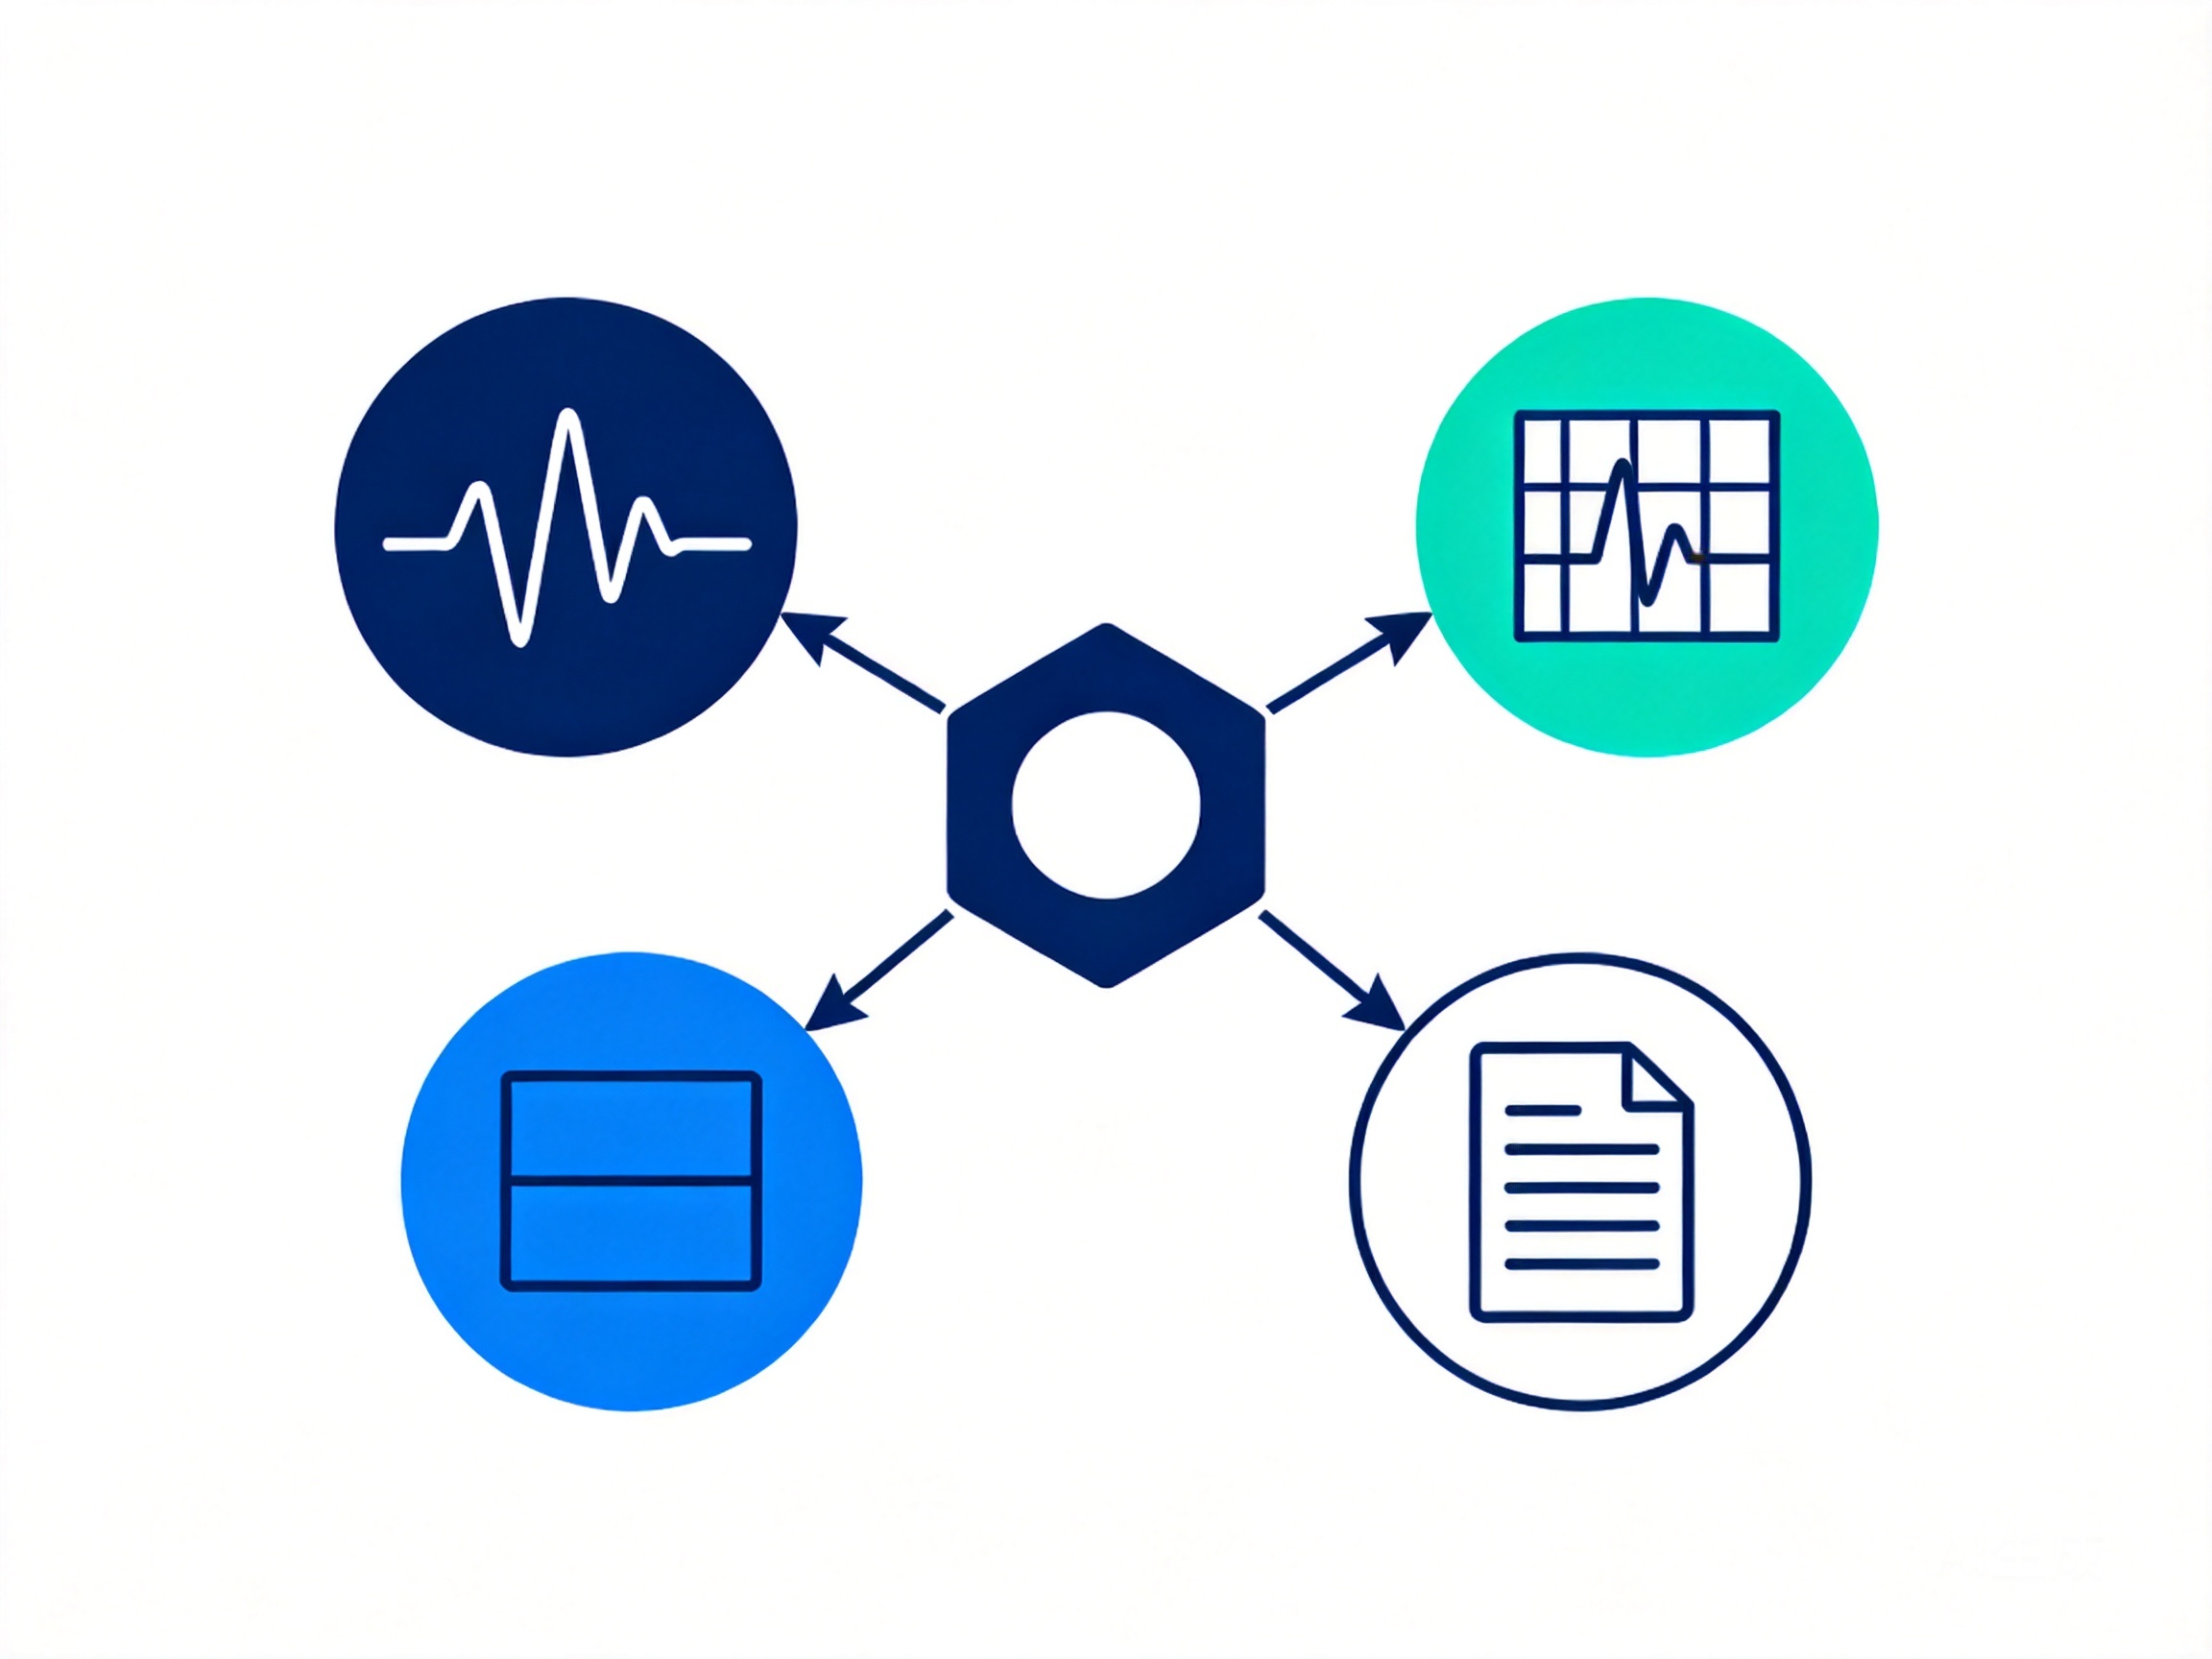
它的核心思路可以一句话概括:对海量现成的临床数据做“二次价值挖掘”,把同一段心电的四种表达方式用统一标识符锁在一起。
- 原始波形:机器可直接计算的数字信号;
- 绘制图像:医生实际看诊时依赖的高分辨率心电图图像,保留视觉形态信息;
- 逐拍参数:从每个导联提取的逐拍量化参数,支撑细粒度分析与可解释性;
- 文本解释:由大语言模型生成的详细文本解释,提供语义与推理逻辑。
数据集构建方法:80 万份记录的“二次开发”与对齐
MEETI 不是从零采集,而是基于开源数据库里的 MIMIC-IV-ECG(含 80 余万份 12 导联心电图记录)做系统性深度开发。
- 统一标识对齐:每一条记录都用唯一标识符,把波形、图像、参数、文本四个组件一一对齐,避免模态之间“对不上号”。
- 文本解释生成:用大语言模型为心电生成详细解释文本,弥补了传统数据集“有信号、无语义”的缺口。
- 开放与可获取:约 1 万条多模态样本放在 Zenodo,因 Zenodo 单库 200GB 上限,完整数据集托管在 Hugging Face 的 PKUDigitalHealth/MEETI 仓库,采用 CC BY 4.0 协议。
这种“结构化医疗数据 + 医疗 NLP 数据集”并举的设计,让同一段心电既能用于信号分析,也能用于图像理解和文本推理。
数据说话:从“单模态识别”走向“多模态逻辑推演”
MEETI 的价值,在于它把心电 AI 的研究范式往前推了一步:
| 维度 | 传统心电数据集 | MEETI |
|---|---|---|
| 模态 | 单模态,或信号-文本 | 波形+图像+参数+文本四模态 |
| 文本解释 | 多缺失 | LLM 生成详细解释 |
| 逐拍参数 | 多缺失 | 逐导联逐拍量化 |
| 对齐方式 | 弱 | 唯一标识符严格对齐 |
团队指出,MEETI 的发布标志着 AI-ECG 研究正在从单一的“信号识别”向“多模态逻辑推演”的学术范式演进。它既为具备跨模态理解能力的医疗大模型提供了数据基石,也为心血管疾病辅助决策提供了可复现的基准测试集。
应用前景与局限
MEETI 的想象空间,主要在可解释的心血管 AI:
- 跨模态心电大模型:让模型同时吃波形、图像、文本,做更贴合医生思维的推理。
- 报告生成与解释:借助文本解释对齐,训练能“说出依据”的心电解读模型。
- 细粒度风险分析:逐拍参数为心律失常、心肌缺血等提供了更细粒度的特征。
局限同样要讲清楚:
- 解释文本由 LLM 生成,不是医生逐条人工校验,可能存在事实性偏差,需要后续临床专家复核;
- 数据来自 ICU(重症监护)人群,分布偏重症,外推到普通门诊/体检人群时要谨慎;
- 派生自 MIMIC-IV-ECG,本质是“二次开发”而非全新采集,标注的临床标准仍依赖上游数据库。
结论
MEETI 用一套“四位一体”的对齐设计,回答了心电 AI 最痛的一个问题:没有多模态开源数据,跨模态心电模型就无从训练。
它的启示在于:开源医学数据集的建设,未必都要从零采集——把已有海量临床数据做结构化、多模态的二次挖掘,同样能产出高价值的数据底座。对医疗 AI 而言,一份能把信号、图像、参数、文本严格对齐的开源数据集,比单个更强的模型更难复制,也更有长期价值。
相关问题
医疗AI训练数据怎么获取?
MEETI 给出了一条成本可控的路径:不一定要从零采集标注,而是对 MIMIC-IV-ECG 这类既有开源临床数据做二次开发,把波形、图像、参数、文本多模态对齐。这种方式可规模化,前提是尊重上游数据库的授权协议(MEETI 为 CC BY 4.0)并做好脱敏合规。
多模态心电数据集和传统心电数据集差在哪?
传统心电数据集多为单模态,最多做到信号-文本两两配对,模型难以结合视觉形态和语义逻辑;MEETI 把原始波形、绘制图像、逐拍参数、文本解释用唯一标识符严格对齐,支持 transformer 多模态学习和可解释推理,是从“信号识别”迈向“多模态逻辑推演”的关键一步。
MEETI 数据集在哪里下载?
完整数据集托管在 Hugging Face 的 PKUDigitalHealth/MEETI 仓库;因 Zenodo 单库 200GB 上限,约 1 万条多模态样本放在 Zenodo(DOI 10.5281/zenodo.18523205),采用 CC BY 4.0 协议,论文的数据可用性声明里写明了具体入口。
| 论文标题 | MEETI: A Multimodal ECG Dataset from MIMIC-IV-ECG with Signals, Images, Features and Interpretations(MEETI:基于 MIMIC-IV-ECG 的信号、图像、特征与解释多模态心电数据集) |
| 作者 | Deyun Zhang、Xiang Lan、Shijia Geng、Qinghao Zhao、Sumei Fan、Mengling Feng、Shenda Hong(通讯) |
| 机构 | 北京大学健康医疗大数据国家研究院、安徽中医药大学、新加坡国立大学、中国科学院、北京大学人民医院、心声医疗科技(HeartVoice Medical Technology)等 |
| 期刊 | Scientific Data(Nature Portfolio) |
| 发表时间 | 2026 年 2 月 26 日 |
| DOI | 10.1038/s41597-026-06796-1 |
| PubMed | PMID 41741503 |
论文原文信息地址:https://www.simodata.cn/blog/2026-09-28-meeti-multimodal-ecg/
参考文献
- Zhang D, Lan X, Geng S, Zhao Q, Fan S, Feng M, Hong S. MEETI: A Multimodal ECG Dataset from MIMIC-IV-ECG with Signals, Images, Features and Interpretations. Scientific Data, 2026. DOI: 10.1038/s41597-026-06796-1
- Gow B, Pollard T, Nathanson LA, Johnson A, Moody B, Fernandes C, et al. MIMIC-IV-ECG: Diagnostic Electrocardiogram Matched Subset (version 1.0). PhysioNet, 2023. DOI: 10.13026/4nqg-sb35