医学影像数据集如何支撑糖尿病视网膜病变筛查?MMRDR 多模态眼底影像数据集解读
MMRDR 是目前模态覆盖最完整的糖尿病视网膜病变开源数据集之一:把彩色眼底照相(CFP)、光学相干断层扫描(OCT)、超广角成像(UWF)三种模态统一到一个基准,共 24,460 幅影像,附带病灶级标注与 DR/DME 严重程度分级,CC BY 4.0 开源(Figshare),并配套评测基准揭示基础模型与大视觉语言模型在眼底任务上的性能缺口。
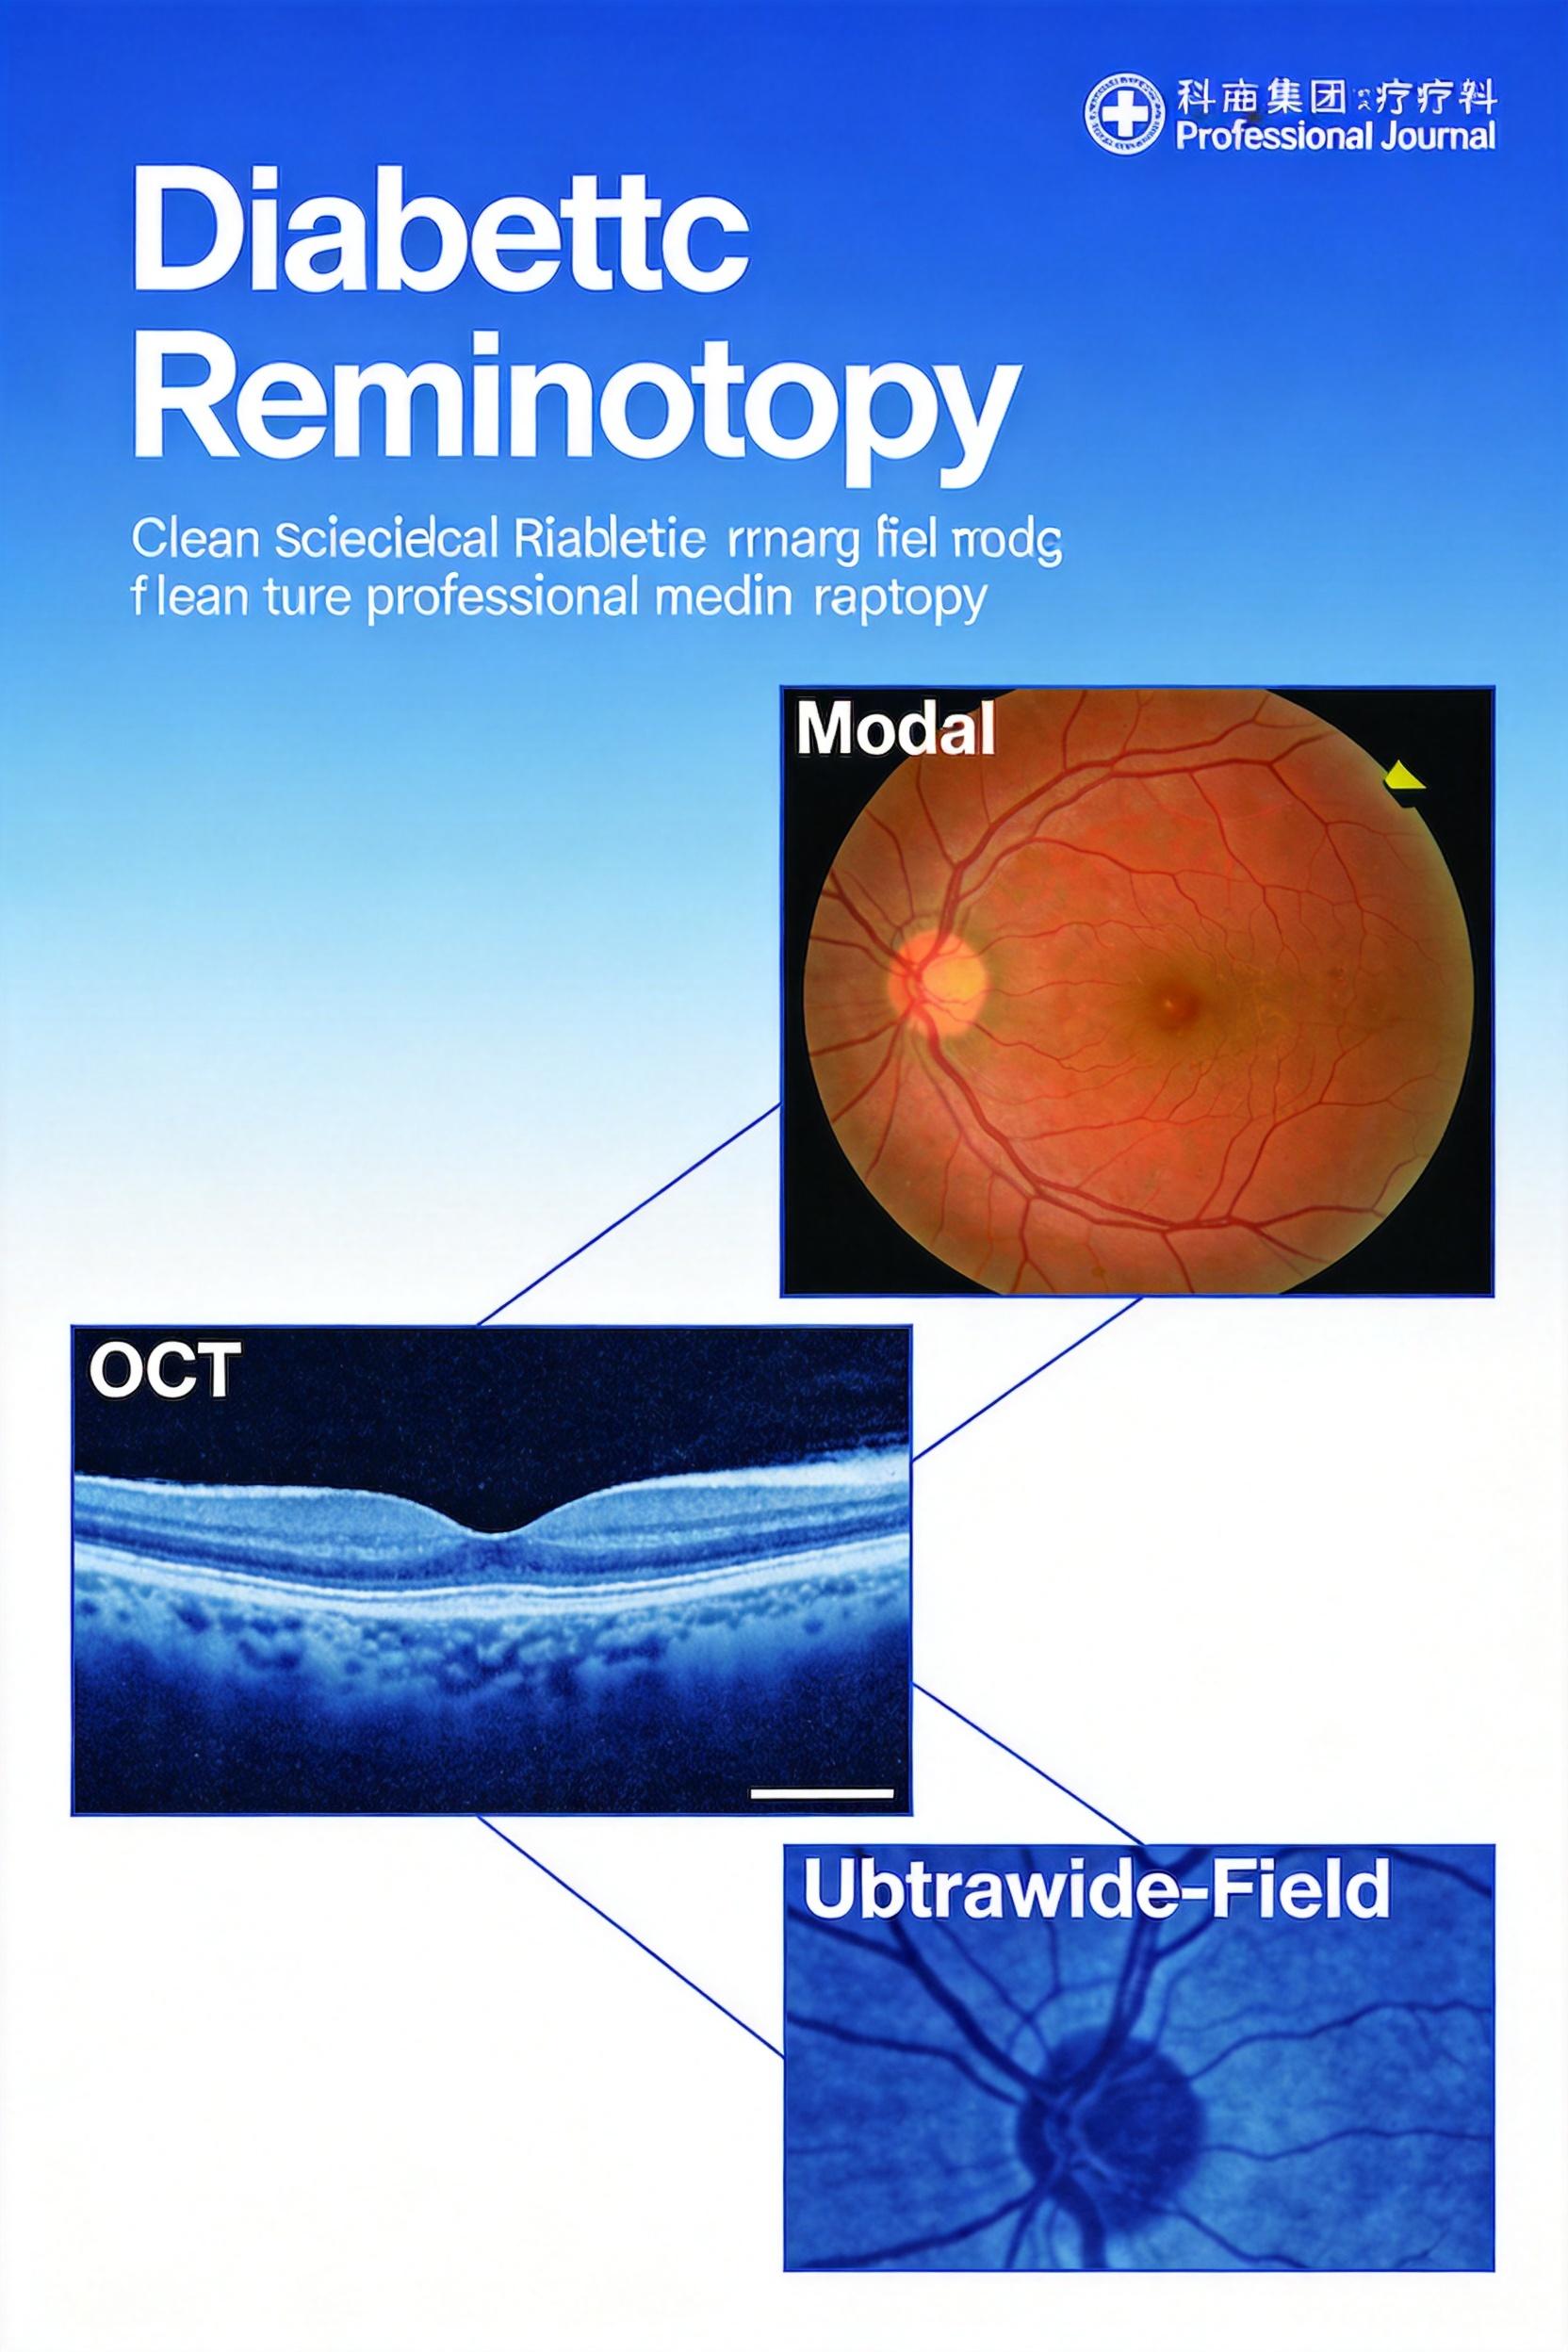
做糖尿病视网膜病变(DR)AI 的人,卡点往往不在模型,而在数据:公开数据集要么只有单一模态、要么缺少病灶级标注,很难支撑"贴近真实诊疗流程"的评测。新近上线于 Scientific Data 的 MMRDR(Multi-Modal Retinal Diabetic Retinopathy Dataset,多模态视网膜糖尿病视网膜病变数据集),把彩色眼底照相(CFP)、光学相干断层扫描(OCT)、超广角眼底成像(UWF)三种模态收进同一个基准,共 24,460 幅影像,附带病灶级标注与 DR/DME 严重程度分级,并以 CC BY 4.0 开源。这篇解读带你看看这套医学影像数据集是怎么搭的、能拿来干什么。
研究背景:糖尿病视网膜病变 AI 为什么"缺数据"?
糖尿病视网膜病变是全球工作年龄人群首要的可预防性致盲眼病,早筛早诊是控制视力损伤的关键。AI 眼底判读被视为大规模筛查的希望,但模型要落地,首先卡在数据上。
公开眼底数据集的短板很具体:
- 模态单一:多数公开集只有彩色眼底照相一种模态,缺乏 OCT 与超广角等临床常用影像;
- 标注粒度粗:很多数据集只给"有无病变"的图像级标签,缺少病灶级(lesion-level)细粒度标注;
- 脱离真实流程:临床诊断是"多模态 + 多步"的,单一模态数据无法还原完整的诊疗路径。
更麻烦的是,评测口径不一。不同团队用不同数据集、不同划分,导致模型泛化能力难以横向比较。MMRDR 正是奔着这几道痛点来的。
创新点:MMRDR 如何用"三模态 + 病灶级标注"破局?
MMRDR 的核心思路是把"多模态覆盖"和"细粒度标注"合到一个基准里。它是目前该领域模态覆盖最完整的公开数据集之一,三大关键设计:
- 三模态对齐:CFP(彩色眼底照相)+ OCT(光学相干断层扫描)+ UWF(超广角成像),覆盖从常规筛查到黄斑评估的完整临床路径;
- 病灶级标注:不仅给 DR 严重程度分级,还提供病灶级标注,覆盖糖尿病黄斑水肿(DME);
- 标准化基准:统一评测眼底基础模型(foundation models)与大视觉语言模型(large vision-language models),把"模型行不行"变成一个可复现的问题。
这套设计回答了一个长期被忽视的问题:医疗 AI 训练数据好不好,不在图多,而在它能不能还原真实诊疗场景、能不能支撑可复现的评测。
数据集构建方法:质控与标注怎么做?
一份严谨的医学影像标注数据,构建链路必须透明。MMRDR 的构建分三步:
| 环节 | 做法 | 意义 |
|---|---|---|
| 数据来源 | CFP 来自公开 OIA-DDR;UWF 与 OCT 来自青岛眼科医院 2021.01–2024.06 的回顾性队列 | 兼顾可复用与真实临床分布 |
| 质控清洗 | 剔除严重模糊/过曝/欠曝、伪影、黄斑中心偏移、激光斑/硅油等不合格影像 | 保证标注质量与判读一致性 |
| 标注分级 | 病灶级标注 + DR(无/轻/中/重/增殖 5 级)+ DME 分级 | 提供可用于监督的细粒度标签 |
质控细节值得留意:它明确排除"激光斑、硅油填充等严重视网膜疾病导致影像失真"的样本,避免把图像伪影当成疾病信号——这正是很多眼底 AI 模型的"聪明汉斯"式捷径来源。
数据说话:规模、构成与评测基准
从规模看,MMRDR 的体量相当可观:
- CFP:13,673 幅(源自公开 OIA-DDR),质控后保留 11,118 幅;
- UWF:15,928 幅,来自 9,185 名患者,质控后保留 10,404 幅;
- OCT:4,012 幅,来自 2,717 名患者,质控后约 2,900 幅;
- 合计:24,460 幅,约 18.6 GB,CC BY 4.0 开源。
评测维度上,团队用一套眼底基础模型与大视觉语言模型在 MMRDR 上做了基准测试,揭示了现有模型在眼底任务上的性能缺口与领域特有挑战——尤其是在病灶级识别与多模态协同上,通用模型仍有明显短板。数据集托管在 Figshare,评测代码同步开源,保证可复现。
应用前景与局限
MMRDR 打开了几条实际路径:
- DR 分级与 DME 检测:多模态数据支撑更贴近临床的分级模型训练;
- 病灶级检测/分割:病灶级标注可用于细粒度识别研究;
- 眼底基础模型评测:作为统一基准,横向比较不同基础模型与 VLM 的眼底能力。
局限也要正视:
- 标签依赖回顾性队列:UWF/OCT 来自单中心回顾性数据,跨机构泛化仍需验证;
- CFP 沿用公开集:CFP 子集源自 OIA-DDR,其固有偏倚会带入;
- 评测以图像级为主:病灶级、多模态协同的评测指标仍有扩展空间。
结论
眼底 AI 的瓶颈,正在从"模型不够强"转向"数据不够全、不够细、不够贴近诊疗"。MMRDR 用**“三模态 + 病灶级标注 + 标准化基准”**的组合,把糖尿病视网膜病变数据集从"单模态图像库"升级为"贴近真实诊疗流程的评测底座"。
它的启示很直接:一份真正好用的医学影像数据集,价值不在图有多少张,而在它能否还原诊疗路径、能否支撑可复现的横向评测。 对做眼底 AI、做医疗 AI 训练数据的团队来说,与其在单一模态里堆量,不如先想清楚——你的数据能不能"还原一次真实的眼底检查"。
相关问题
医学影像数据集哪里下载比较靠谱?
MMRDR 这类数据优先从官方平台获取:数据集托管在 Figshare(DOI 10.6084/m9.figshare.29423747.v2),评测代码开源在 GitHub,论文以 CC BY 4.0 许可开放。获取时认准论文数据描述符(Data Descriptor)中给出的官方 DOI 与平台链接,避免从二手网盘或来路不明的镜像下载,以免拿到标注错乱或版本不一致的数据。
医疗数据标注怎么做才可靠?
可靠标注的核心是"真值可溯源、流程透明、质控严格"。以 MMRDR 为例,它先明确数据来源与纳入排除标准,再剔除模糊、过曝、伪影、黄斑中心偏移等不合格影像,最后给出病灶级标注与 DR/DME 严重程度分级——每一步都可复现。做医疗数据标注时,应优先建立可量化的质控标准,而不是只看标注数量。
多模态眼底影像数据对糖尿病视网膜病变 AI 有什么价值?
多模态影像能还原真实诊疗路径:CFP 看眼底血管与渗出,OCT 看黄斑水肿的层状结构,UWF 看周边视网膜病变。三者互补,才能覆盖从筛查到分级诊断的完整流程。MMRDR 把三模态 + 病灶级标注统一到一个基准里,让模型评测更贴近临床,这是单模态眼底数据集难以替代的价值。
| 论文标题 | A multimodal retinal image dataset for diabetic retinopathy detection using foundation models(基于基础模型用于糖尿病视网膜病变检测的多模态视网膜图像数据集) |
| 作者 | Zhenyu Tang、Lilong Wang、Zhen Guo、Qianqian Liang、Shuyue Xue、Chengcheng Feng、Lili Ran、Lingzhi Chen、Xiaosong Wang、Jun Li(李君,通讯作者) |
| 机构 | 山东第一医科大学附属青岛眼科医院、上海交通大学、上海人工智能实验室、山东第一医科大学眼科学研究所 |
| 期刊 | Scientific Data(Nature Portfolio),2026 年第 13 卷 |
| 发表时间 | 2026 年(2025-07-21 投稿 / 2026-02-27 接收) |
| DOI | 10.1038/s41597-026-07005-9 |
| 数据获取 | Figshare 开源(DOI 10.6084/m9.figshare.29423747.v2),许可 CC BY 4.0 |
论文原文信息地址:https://www.simodata.cn/blog/2026-10-19-mmrdr-diabetic-retinopathy/
参考文献
- Tang Z, Wang L, Guo Z, Liang Q, Xue S, Feng C, et al. A multimodal retinal image dataset for diabetic retinopathy detection using foundation models. Scientific Data, 2026, 13. DOI: 10.1038/s41597-026-07005-9
- Li T, Gao Y, Wang K, Guo S, Liu H, Kang H. Diagnostic assessment of deep learning algorithms for diabetic retinopathy screening. Information Sciences, 2019, 501: 511-522. DOI: 10.1016/j.ins.2019.06.011